AI复刻爆款:用 Codex 复刻爆款卖货视频的实践
选择场景,分别对照同一动作。
左侧为原视频,右侧为约 30 秒的 AI 测试片段。可同时播放,也可用各自的播放器单独观看;场景按动作定位,分段时点为约数。
这次改编沿用“先试吃吸引注意,再开袋展示、倒出分量、举片讲口感,最后引导购买”的销售骨架。人物从原片中的女子换成指定的眼镜男子,商品从猪油渣换成红薯片,包装随之更新;环境仍采用桌前展示与暖灯背景,但陈设和器皿有所变化,原片的金属托盘在生成版中变成了木色圆盘。
改编的目的,是让新视频拥有自己的出镜主体、商品信息和视觉呈现,减少对参考片具体内容的直接照搬。人物、环境和商品的替换本身,不能保证平台不会判定抄袭。本次复用的是销售表达的组织方法,也需要检查成片是否真正实现了这些改编要求。
具体制作分为三步:先用 Codex 拆解参考视频的动作与叙事,再按新人物和新商品改写分镜,最后把提示词和三张参考图交给小云雀生成。分镜设计保留原片的销售推进顺序,生成后再对照检查人物、商品与动作是否符合分镜要求。
原片约 49.78 秒,本次生成的测试片段约 30.05 秒。这次先测试了约 30 秒的内容,尚未将完整分镜全部生成视频。测试画面里已经能看到指定类型的人物、红薯片,以及咬食、开袋、倒片、举片展示等动作;其中需要改进的是盘中食物状态的连续性。
对于想尝试 AI 卖货视频的人,这个案例能提供一条具体的制作路径,也能帮助判断生成后还需要检查什么。
从原片里拆出可以沿用的动作
原视频是一条竖屏零食展示视频。女子坐在桌前,金属托盘里堆满食物,先咬一口,再开袋、倾倒、展示分量,随后举起食物介绍口感,最后拿包装收尾。
它的画面相对集中:一个人、一张桌子、一盘食物。销售信息随着动作展开,观众能同时看到商品的形态、分量和试吃表现。
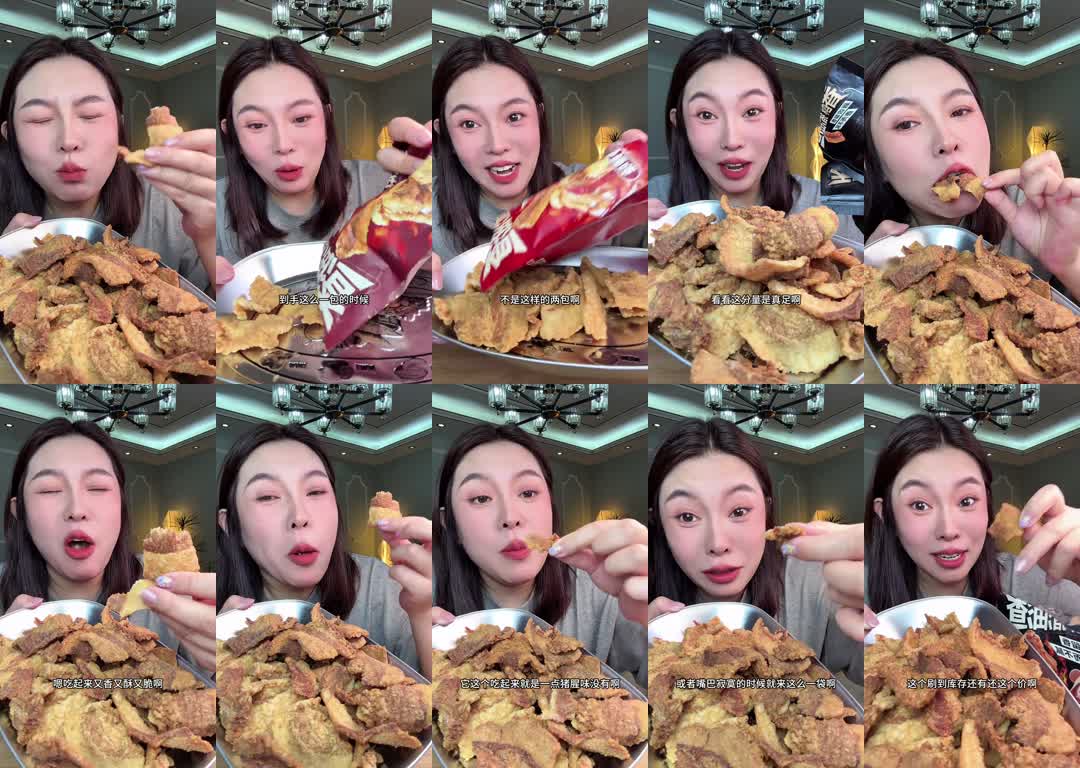
原片每 5 秒抽取一帧,按从左到右、从上到下排列。图片用于观察画面结构。
拆解时,将原视频交给 Codex,并调用自行调试的 nanyin-fkvideoskill。它先提取切镜候选、代理帧、字幕样本和音频,再判定哪些变化属于真实切镜,哪些只是手部或食物运动。
这一点会直接影响分镜质量。拿起食物、送入口中、咬下、抽离、咀嚼,可能发生在同一个固定镜头里。如果每个动作都被写成一次切镜,生成后的节奏就会偏离参考片。
最终输出把约 50 秒的内容划分为 9 个动作段。这 9 段包含同一镜头内的动作延续,不能直接理解成 9 次切镜。
| 原片时间 | 动作段 | 在卖货表达中的作用 |
|---|---|---|
| 0.000–3.433 秒 | 咬食开场 | 先呈现食物与试吃动作 |
| 3.433–6.000 秒 | 撕袋展示 | 让包装进入画面 |
| 6.000–9.500 秒 | 倾袋倒出 | 展示开袋后的商品 |
| 9.500–12.000 秒 | 再撕一袋 | 为下一次分量展示做准备 |
| 12.000–17.500 秒 | 加量满盘 | 用堆叠画面表现分量 |
| 17.500–21.500 秒 | 指盘选片 | 展示单片形态 |
| 21.500–32.500 秒 | 举片试吃 | 配合口感描述 |
| 32.500–44.500 秒 | 续吃推荐 | 引入日常食用场景 |
| 44.500–49.779 秒 | 举袋收尾 | 回到商品与购买引导 |
这张表相当于后续改编的骨架。商品和人物可以换,动作为什么出现在这里、下一段如何接上,仍然需要保留。
换商品时也要重写销售理由
接下来的要求很明确:把整个视频改为卖红薯的文案,人物换成指定图片中的男子。
结合商品参考图,改编对象被落实为红薯片。人物则统一描述为短黑发、长方形黑框眼镜、灰色圆领短袖的成年男子。
商品也有具体的视觉描述:金橙色、不规则薄片、天然纤维纹理,以及深色薯皮边。这样,后续的举片、转动和试吃动作,都有了明确的展示对象。
文案随商品一起调整。原片围绕猪油渣展开的介绍,被改成红薯片的开袋即食、片形、香甜与酥脆,以及追剧、下午嘴馋等食用场景。
这里需要留意:生成的销售文案包含了“三大包”“原薯切片”等说法。这些是脚本中的表达,不能仅凭参考图片确认。正式使用前,需要用实际商品规格和资料逐项核对,不能把 AI 补出的卖点直接当成商品事实。
本次改编能说明如何迁移卖货视频的结构,尚不能说明这些文案已经适用于真实商品链接。
包装要在所有相关动作里同步替换
第一版红薯片改编使用了无字暖橙色食品袋。随后又提供了实际包装参考图,要求统一替换。
新包装被描述为米白色上半部、暖黄色下半部,顶部有红色品牌色块,正面包含红薯插画、红色图形布局与纵向透明展示窗。
包装会出现在撕袋、倒片、再次开袋、加量满盘和结尾举袋这些位置。更新时,Codex 把相关动作段里的包装描述一起改了,而不是只修改开头的总说明。
这一步留下了一个实用做法:每次替换商品资产,都沿着它在视频中出现的位置检查一遍。否则,一段使用新包装,另一段仍描述旧袋子,生成时就会出现互相冲突的要求。
把动作顺序写进生成提示词
最终分镜没有只写“男子展示红薯片”,而是分别列出场景、构图、主体、微表情、动作、背景动态、镜头,以及可以提交的 Seedance 提示词。
以倒片为例,动作顺序被写成:抬高袋底、压低袋口、轻晃袋身,让红薯片从袋口落入托盘。
举片试吃则包含:把薯片举近镜头、转动展示、送入口中咬下、抽离剩余部分、咀嚼,再举起残片。
这些描述把一个概括的“试吃”拆成了前后相接的动作。对后续检查也更有帮助:可以具体查看食物是否从正确的位置进入嘴部,咬过之后的残片是否接得上,而不只判断人物有没有做出吃东西的姿势。
不过,历史母稿仍使用了“同前,无变化”和“第二张人物图”这样的引用。整份提交时可以结合上下文理解;如果拆成多次独立生成,更稳妥的做法是在每段重复必要的场景与人物描述,并明确哪张图对应人物、商品和包装。
小云雀生成的 30 秒测试片段
小云雀回放显示,这次任务使用 Seedance 2.5,选择 720P,并附带人物、商品和包装三张参考素材。
本次先生成约 30 秒进行测试,完整母稿尚未全部生成视频。回放页面可见的提交文本到“举片试吃”段结束,“续吃推荐”和“举袋收尾”两段没有出现在当前可见文本中。下文对照的是这次测试片段,完整分镜仍保留后续推荐与购买收尾。
本地文件进一步确认了两支视频的参数:
| 项目 | 原视频 | 本次测试片段 |
|---|---|---|
| 时长 | 49.779 秒 | 30.050 秒 |
| 分辨率 | 1080 × 1920 | 720 × 1280 |
| 画幅 | 9∶16 | 9∶16 |
| 音频轨 | 有 | 有 |
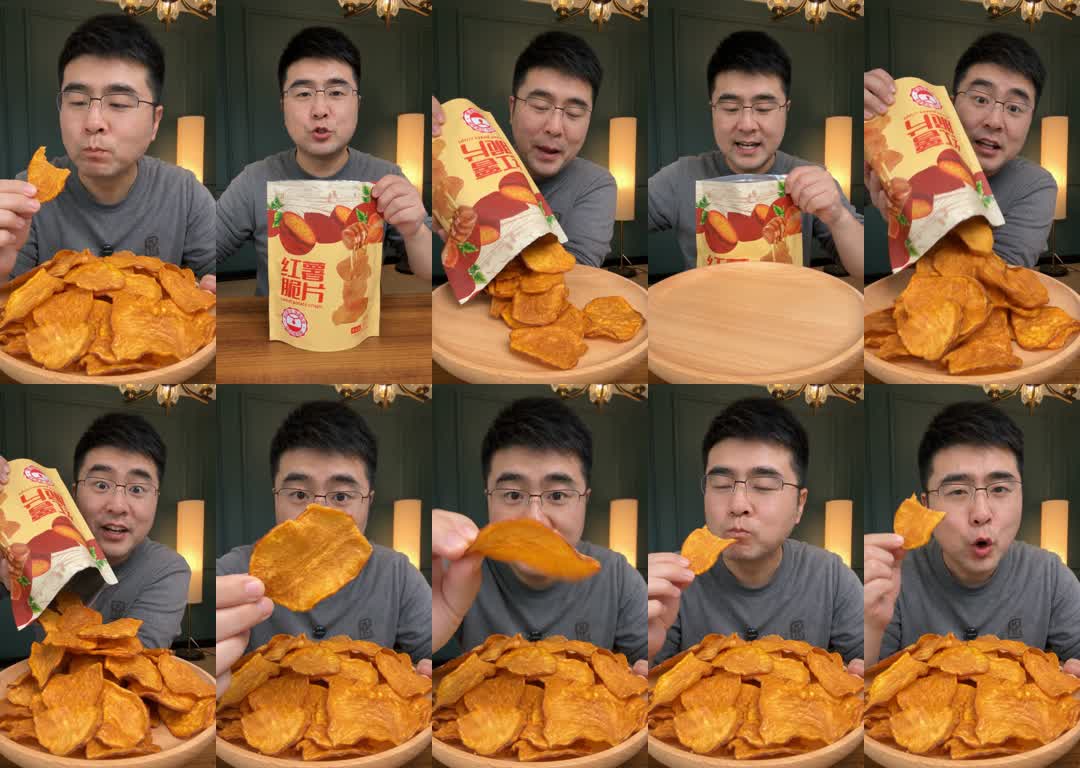
生成视频每 3 秒抽取一帧,按从左到右、从上到下排列。
在这些抽样画面中,短发、眼镜、灰色上衣等人物特征保持可辨,桌前场景也延续了深色墙面与暖色灯光的组合。商品已经换成金橙色薯片,动作从咬食、开袋和倾倒,推进到举片展示与再次咬食。
这些画面说明,人物、商品和主要动作的替换已经在测试片段中呈现出来。对这一条素材而言,Codex 整理的分镜可以成为小云雀生成视频的输入。
测试片段中的口播时间与母稿有所不同。本地自动转写把“红薯香甜好吃,可自己做太麻烦了”识别在 0–3.44 秒;母稿原本把这句话安排在约 3.43 秒后的撕袋段。转写还提取到了三大包、单片展示和口感描述。这些自动识别结果仍需听审确认,后续继续生成时,可以结合实际口播节奏检查动作与台词是否对应。
需要改进的是盘中食物的连续性
按每秒抽帧的顺序观察,第一次倒片后盘中已经有薯片,随后再次开袋时又出现了空盘,之后重新倾倒。分镜希望表达连续加量,成片却出现了食物状态重置。
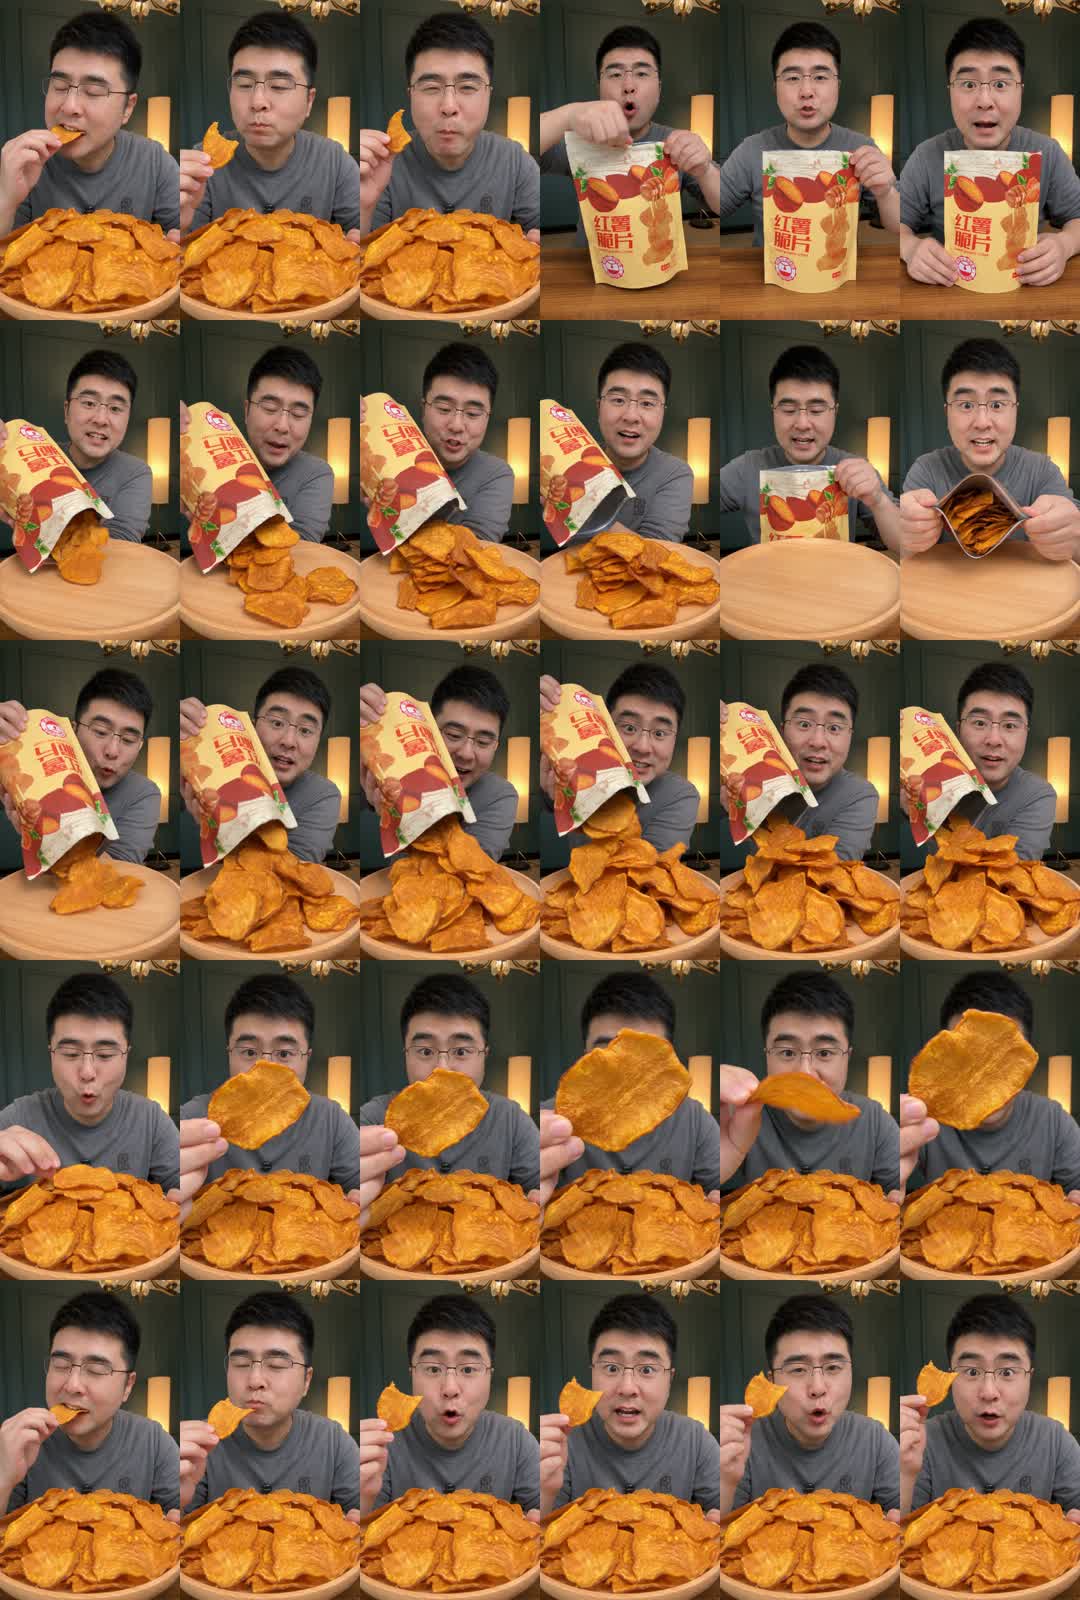
每秒一帧,按从左到右、从上到下排列。第二行至第三行可以对照两次倒片之间的盘中状态。抽帧用于定位问题,不替代连续播放和听审。
这会影响分量展示的可信度。观众看到一盘食物越堆越多,才能直观理解加量;中途换成空盘,就更像重新拍了一次倒片。
下一次可以在再次开袋的段落中写清楚:托盘保留上一段已有的薯片,第二袋倒在原有食物上,盘中数量继续增加。如果采用分段生成,还需要检查上一段结尾与下一段开头的食物堆叠是否衔接。
这次实践可以怎样复用
这条路径适合先做一个范围明确的试验:选择一条人物与场景相对集中的参考片,拆出动作及其销售作用,准备人物、商品和包装素材,再按新商品重写文案,提交生成后逐项对照。
真正需要人工关注的部分已经很具体:商品信息是否真实,包装是否符合要求,手与食物的动作是否接得上,盘中数量是否连续,以及目标时长能否容纳完整口播和收尾。
本次完成了约 30 秒的红薯片视频测试,验证了人物、商品和主要动作的替换,也发现了盘中食物状态需要衔接的问题。声音自然度、口型同步仍需连续播放听审;卖货表现则需要真实发布与转化数据才能判断。
下一步可以先修正盘中食物状态,再继续生成其余分镜,检查推荐、购买引导与结尾能否顺畅接上。