新号纯自然流,3 天从 0 到 157 粉|我用 Codex 搭了个爆款视频复刻工作台
一个用 0 好友微信注册的新视频号,发 AI 图文视频 3 天,靠纯自然流量从 0 涨到 157 粉。我复盘了这次起号的数据,也分享我用 Codex 搭的爆款视频复刻工作台,看看一条视频怎么从拆参考片、写稿、做小样,走到成片审阅和交付。
11 月 9 日,我在一个用 0 好友的微信账号注册的新视频号上发了第一条 AI 图文视频。到 11 日,账号从 0 涨到了 157 粉。
起因是我想给家人找个能小步试试的副业,选了图书带货。前期我只想看看,靠文案、配音和图片做出的视频,有没有人愿意看。比起一上来就用视频模型做动态镜头,我更愿意先试成本更低的图文视频。
为了自动化操作,我花了一两周,用 Codex 搭了个「爆款视频复刻工作台」。我用它拆出参考片的钩子、叙事和节奏,再用全新的画面、配音和配乐做成一条能审、能改、能交付的视频。
01 新号发视频的前三天,从 0 到 157 粉
11 月 8 日,我在一个 0 好友的新微信上注册了视频号,第二天开始发作品。这次我没投流。特意用新号,是想少一点熟人流量的影响,看看作品能从平台推荐里拿到多少播放。
后台选的是 2026 年 11 月 5 日至 11 日这 7 天。曲线从 9 日开始出现新增关注,到 11 日,新增关注 157,净增关注 157,取消关注 0。
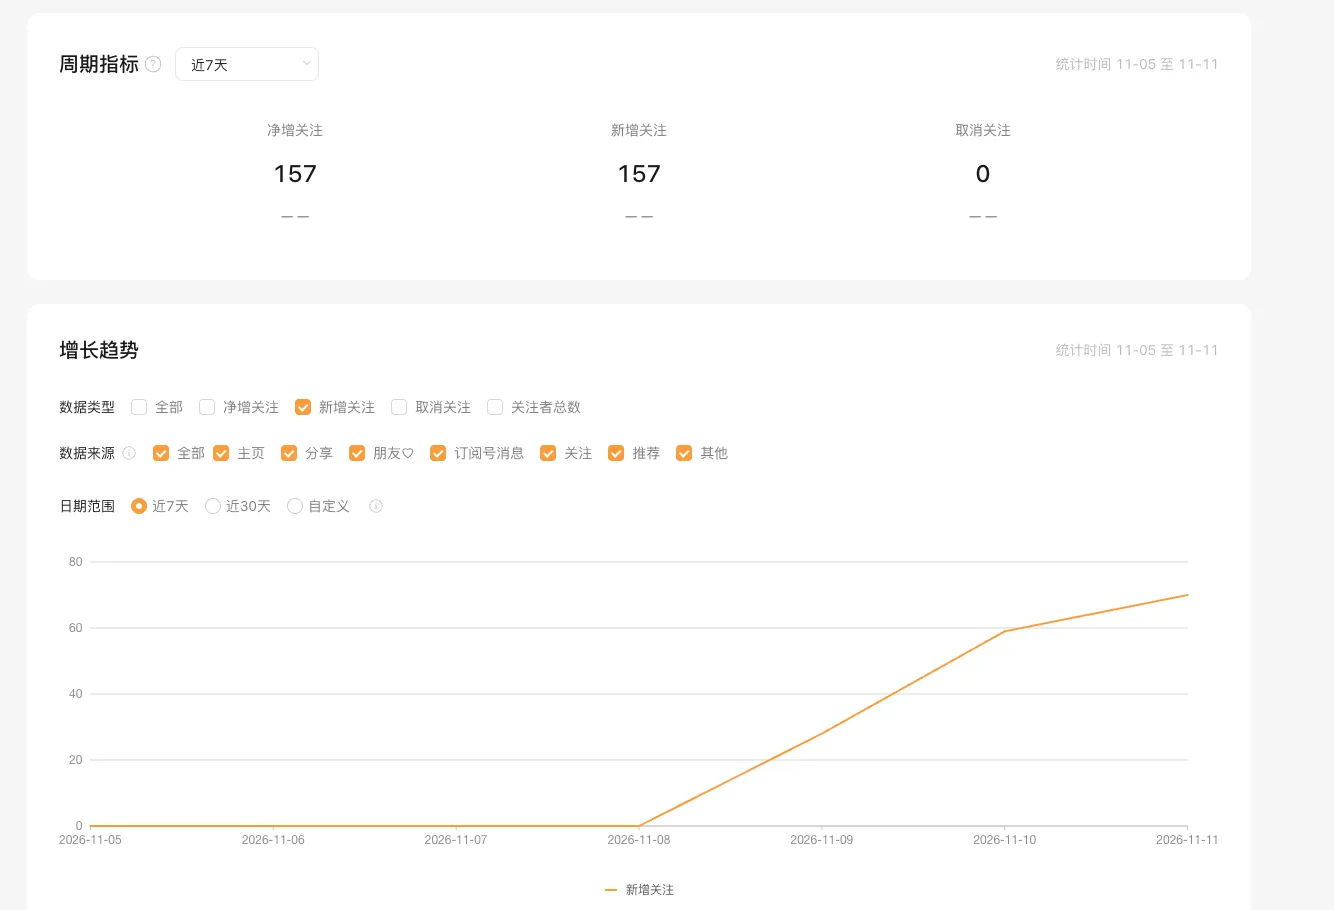
图 1|视频号后台:新增关注从 11 月 9 日开始
同期一共有 14,470 次播放,其中 13,716 次来自推荐,占约 94.8%。还有 207 次播放来自分享。
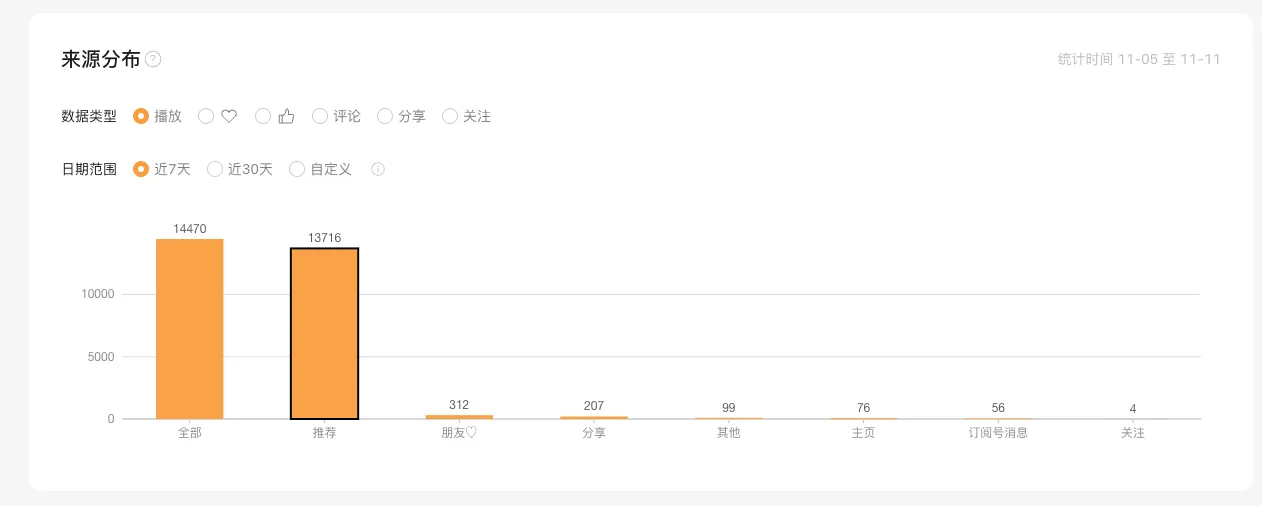
图 2|视频号后台:播放来源分布
对这次试水来说,至少有一个问题有了答案:没有微信好友,发出去的作品也能靠推荐被看见。至于哪条视频、哪个开头更容易带来关注,还得接着发、接着看。
02 为什么要做工作台:一次生成之后,还有很多活
写一段稿、配几张图、加上旁白和字幕,图文视频听起来并不复杂。麻烦的是,改动一处,经常要回到前面几步:脚本改了一句,得重新配音、对字幕;看到成片才发现字太小,还要找出当时用的工程和设置。
做《商纣王》讲解视频时,我就遇到了一个具体问题:字号设置过了检查,成片里的字还是小。 后来量了实际画面,参考片的字幕字高约占画面高度的 6.5%,重制版只有 4.4%。后来我加了一道检查,直接从成片像素测字幕字高。
这也是我做工作台的原因。稿子改过几次、哪个声音试过、眼前是哪一版成片,最好都能在同一个任务里找到。看到问题时,能说清楚改哪一段,再检查回来那一版。
03 核心在拆解:先看懂原片,再写自己的稿
工作台先转写参考片,再标出开场钩子、冲突、反转和揭晓的位置。开头有时就靠一句话抓住人:它先抛出冲突,晚一点才交代背景。如果写新稿时把答案挪到了开头,信息还在,观众等下去的理由就没了。
写脚本时,我会保住这些关键位置,正文再轻改。遇到重复的铺垫,就换成有依据的具体细节。到了脚本方案页,参考稿和新稿可以逐段对照,有疑问就点时间戳回原片听。执行器还会检查字序保留率、稿长和开头钩子的保留情况,提醒我哪些地方可能改过头了。
图书内容里引用的古诗词、典籍原文会单独锁定,逐字核对。有事实修订时,依据另行留档。参考作品、图片、声音和配乐也要分别确认使用条件。
04 它怎么运转:云端管理任务,本机执行制作
我手头这台是 14 英寸 MacBook Pro,配的是 M4 Max 芯片和 64 GB 统一内存。这套配置给本地模型留出了足够的内存,能用已有的机器跑语音转写、配音,做完再直接合成视频。这样试一个新选题时,可以少调用一些外部服务。
实际制作时,大部分模型任务都在本机运行,转写和配音就是两个例子。参考分析、文案、分镜和出图由 Codex 组织。网页收素材、排任务、留版本,Mac 上的执行器领到任务后,把制作结果传回网页。
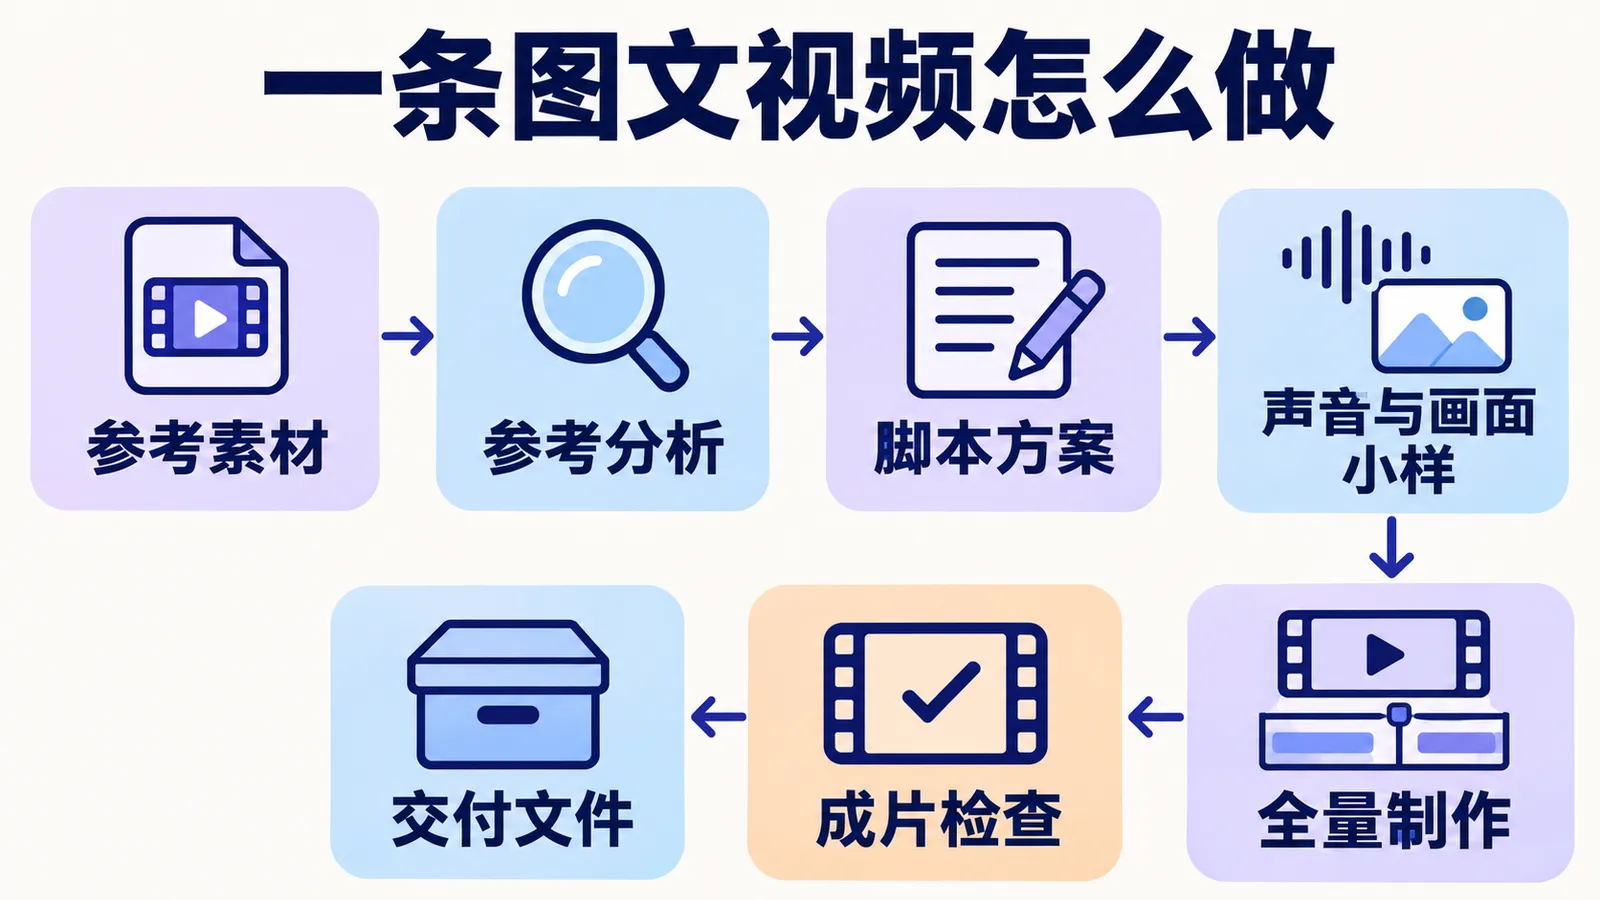
图 3|从参考素材到交付文件的制作流程(示意)
找素材和做视频也接在一起了。账号监测里看到合适的作品,可以下载到参考素材,再批量创建任务。手上已有的参考片也能直接上传。标题、作者和可用的互动数据会随记录保存,互动数是采集时的快照。
同一条参考片想换个音色或风格再做一遍,直接复用已下载的素材。每次制作有独立的任务和成片记录,可以回看比较。作品手动发布后,也可以回到工作台登记。
按我的用量折算,做一条约 5 分钟的图文视频,Codex 的消耗约 1.5 元。下载参考素材另算,我当时用的接口约 0.2 元一条。想算整条视频的制作成本,还得把本机运行和人工审片的投入记下来。
05 从小样到成片,怎么检查和修订
参考片定内容和节奏,模板定表达
原片的画风、色调、主体大小和开场标题样式可以拿来做参考,再生成新画面。工作台里的「历史人物讲解」「本草故事」「庄子静思」等模板,记录的是版式、讲述语气和配乐情绪。某条做得顺,审片通过后可以把用过的风格存成模板,留给同类题材。模板的一次确认率来自审片记录,播放量要到平台后台看。
先看小样,做完再测成片
熟悉的题材可以批量自动做完,再统一审片。换题材或音色时,我会让任务在参考分析、脚本和小样三个节点停下来确认。选音色时可以先听声音库,到了小样就直接听本稿配音,核对人名读音和转折前的停顿。画面也要点开运动样片,看镜头推近会不会抖、字幕会不会遮住人物。
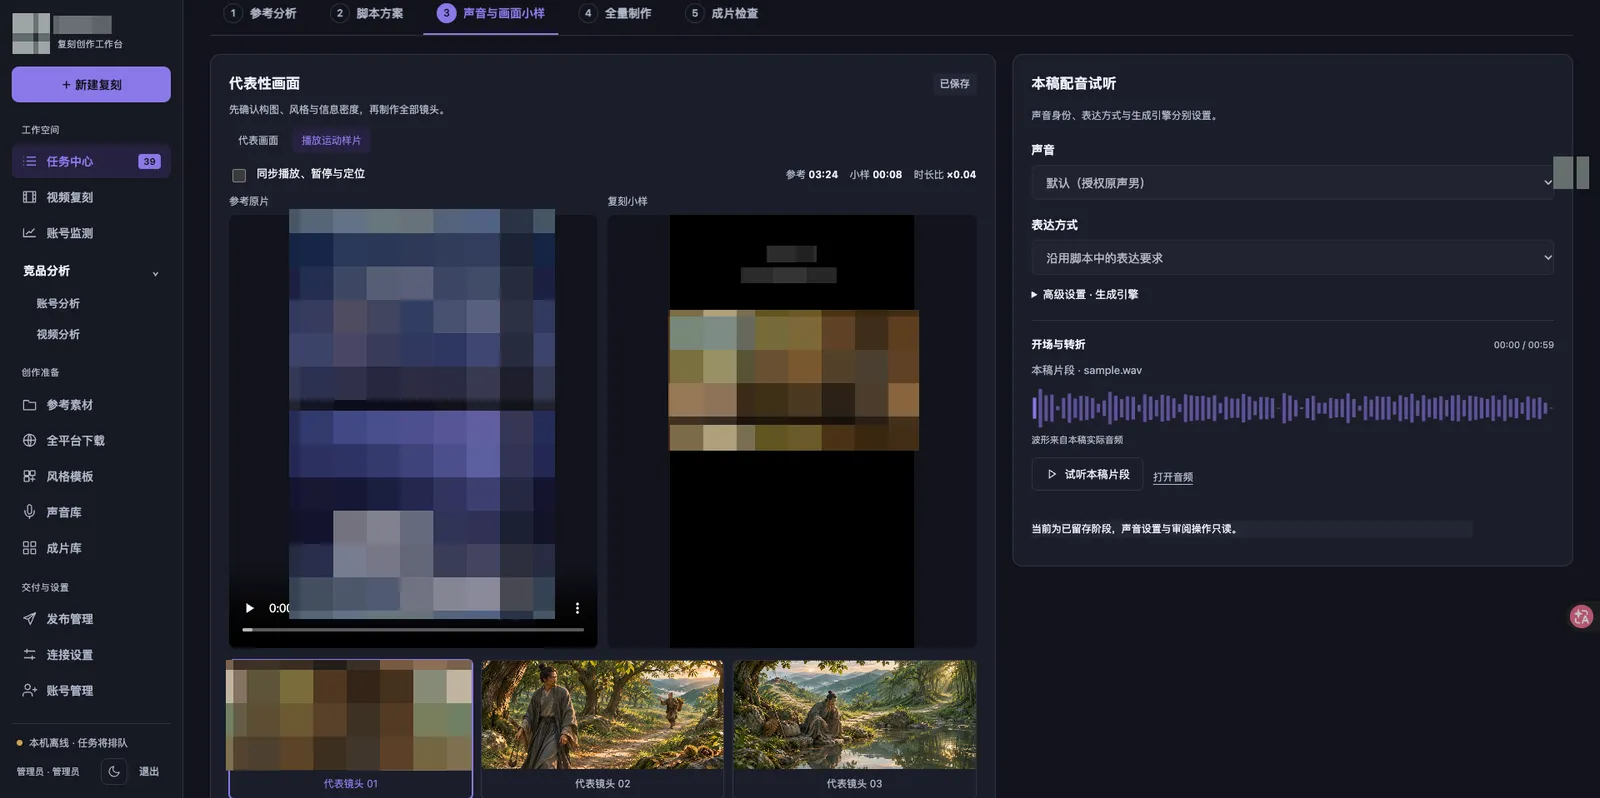
图 4|小样页:左边看代表性画面和运动,右边听本稿配音
正式配音做完后,我用实际音轨定切镜和字幕时间。工作台把成片时长控制在参考片的 0.93–1.05 倍,还会从输出视频测换画频率、字幕字高和混音。片子比原来短了一截,就回头检查是不是旁白念得太快,或者转折的停顿被剪掉了。
在出问题的时间点标记,按清单改
成片能和原片对照播放。比如 00:18 的配乐盖住了旁白,我就在那个时间点记下来,要求压低这段音乐,保留旁白和画面。有可编辑工程时,可以按清单做局部修订:改字幕保留配音,换封面保留视频,前后的版本也都能回看。任务失败时,可以先尝试取回已生成的文件,再决定要不要重跑。
最后我会完整听看一遍,用手机看字幕和封面,听音乐有没有盖住人声。确认后可以下载 MP4 成片、SRT 字幕、3:4 主页封面和 4:3 分享封面。有回传的可编辑工程,也会随版本留存。
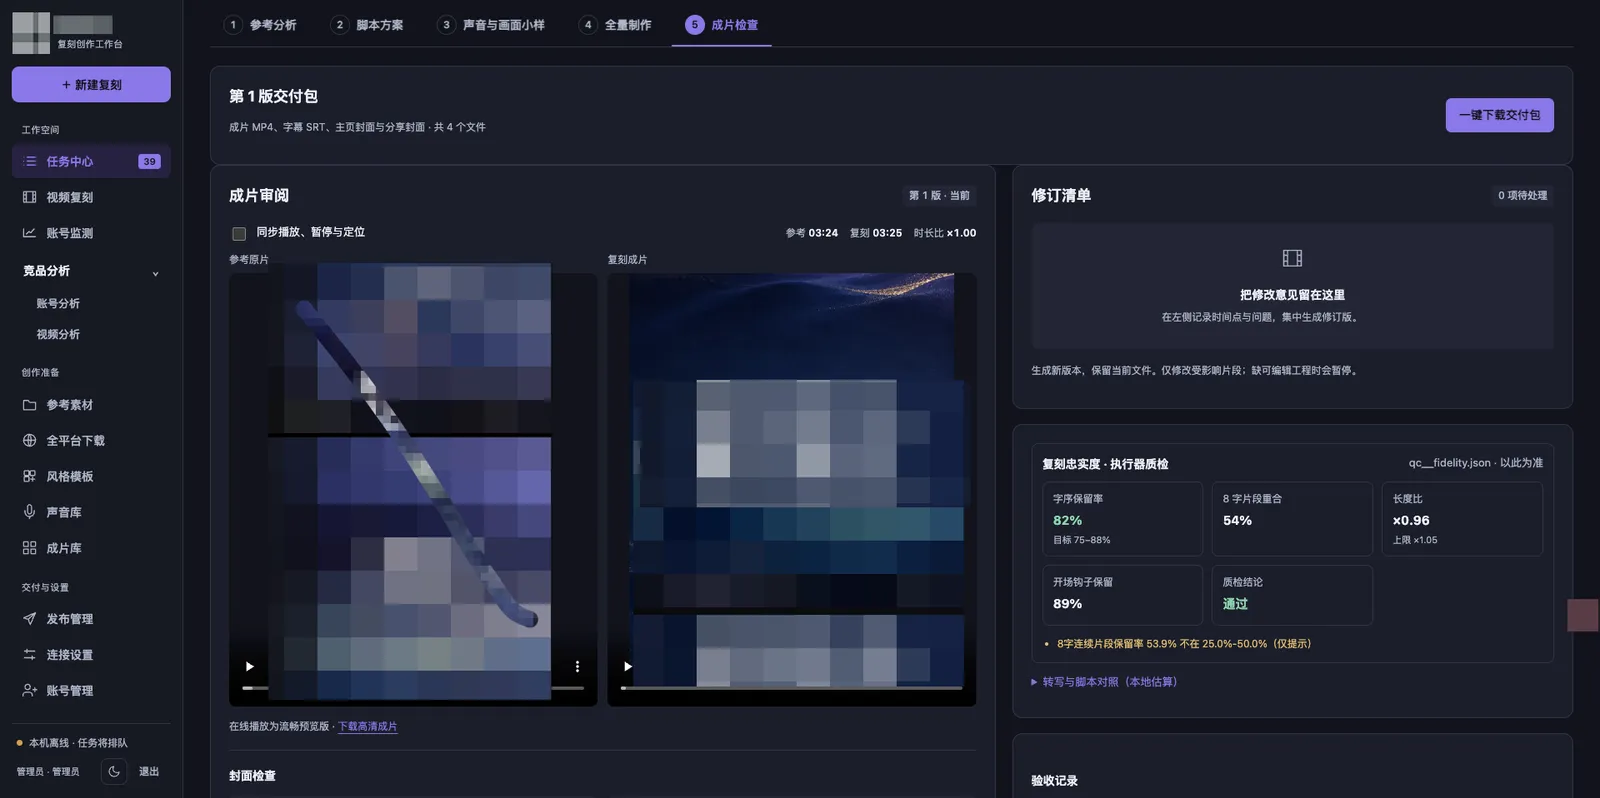
图 5|成片检查页:对照播放、记录修订、下载确认版本的交付包
06 工作台里的四个核心 Skill
复刻任务启动时调用 nanyin-video,由它把各阶段串起来。走到脚本和成片阶段时,执行器再读取另外三个专项 Skill 的规则。
总控 nanyin-video:负责参考拆解、脚本、小样、整片和验收,明确每个阶段用什么材料、交什么成果。
脚本 nanyin-video-script:逐段对照参考稿和新稿,保留钩子、冲突和反转,轻改正文,锁定经典引文。
发布文案 nanyin-video-topic:根据原标题和最终脚本写视频号短标题、描述、话题和置顶评论。标题里抛出的问题,要能在正片里得到回答。
封面 nanyin-video-cover:保留参考封面的文字钩子和视觉层级,用新画面按题材或模板做两版,分别用于 3:4 主页和 4:3 分享。
配音、B-roll(补充画面)和字幕也有各自的子技能,由总控按任务需要调用。
07 接下来我想试的三件事
短剧带货放到第二期。 之前我已经试做过一条短剧,制作过程也写过一篇公众号文章,感兴趣可以翻看那次记录。第二期我想接着试,看看这种内容怎么带货。
图书带货继续跑自然流量。 眼下我更想看看,换一本书、换一条参考素材,再用这套流程做视频,自然播放量能到多少,能不能跑出一条爆款。
粉丝到 1,000 再考虑试投流。 等账号到了这个阶段,我可能会做一次小范围的投流测试,看看播放量和新增关注有什么变化。
08 想做视频或副业,可以先验证一条
如果你也想试视频带货,可以先选一个自己熟悉或想尝试的赛道。找一条参考作品,拆解它的开头,按自己的想法写稿、做成片,再发出去看反馈。
我会先看这套流程能不能自动化,再看自动做出来的成片能不能达到我想要的效果。
这次新号发视频 3 天,靠纯自然流量从 0 涨到了 157 个关注。对我来说,这个结果值得再试几条。
关于作者
我叫殷新伟,号南殷居士,以「南殷用AI」分享实践与思考。我是一名数据与 AI 产品从业者,关注企业 AI 应用、FDE 实战,以及怎么把专业经验做成可复用的产品、技能和工作流。个人站:南殷用AI(nanyinai.vip)。
如果你也在尝试做 AI 视频,欢迎留言说说从选题到发出去,哪一步最费你的时间。
关注公众号「南殷用AI」
用微信扫描下方二维码,或在微信搜一搜搜索「南殷用AI」。
手机上可长按图片识别二维码;点击图片可放大查看。