Claude Fable 5.2 发布:1000 个智能体,30 小时完成费马大定理形式化
新一轮旗舰模型更新,Anthropic 已经出牌。
11 月 9 日发布的 Claude Fable 5.2 和 Mythos 5.2,把这次更新的重点放在了复杂技术项目上:迁移生产服务、设计电子设备、参与物理研究,以及完成数学证明的形式化。
其中最抓眼球的一项,是 Anthropic 披露的费马大定理项目:1000 个 Fable 5.2 智能体协作,30 小时完成形式化,过程中只需要很少的人工介入。
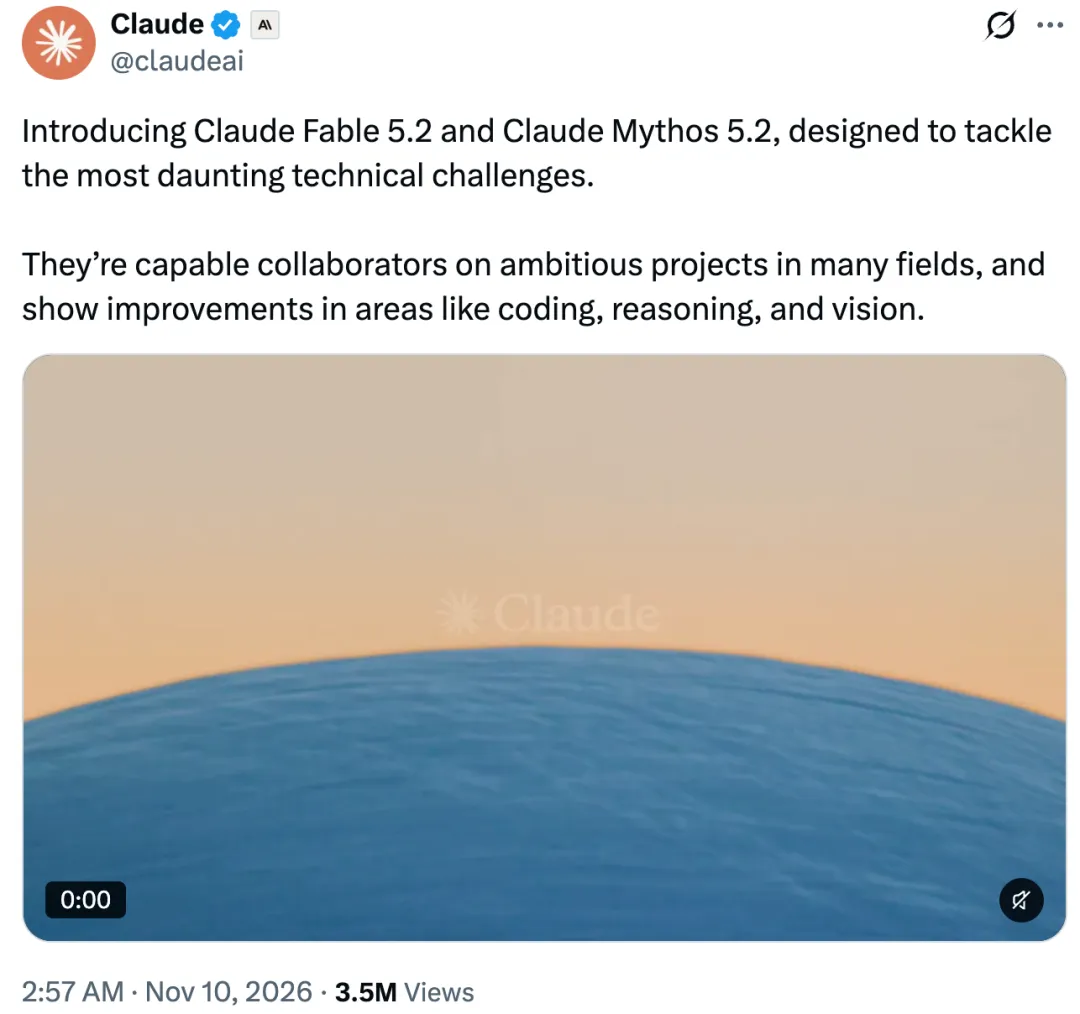
发布信息。操作:打开文末官方发布页,截取模型名称与发布日期;画面要点:Fable 5.2、Mythos 5.2、2026 年 11 月 9 日。此处是官方信息截图,不是作者测试结果
订阅用户还有一项短期福利。Anthropic 按符合条件的付费订阅年限,提供不同次数的 Fable 额度重置。具体适用套餐、次数和有效期,仍要看自己的账户与活动规则。
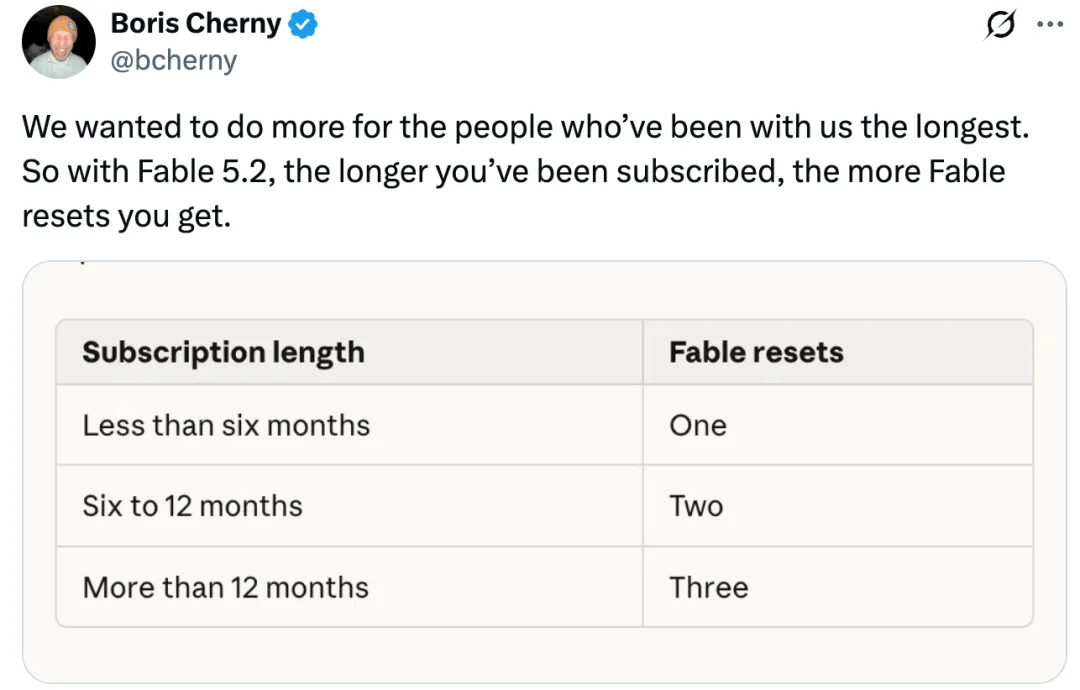
额度重置活动。操作:从官方发布页进入 launch promotion;画面要点:适用套餐、订阅年限与重置次数,不把活动规则写成长期权益
两款模型共用底层能力,开放方式不同。Fable 加上较强的网络安全和生物安全防护,面向更广泛的用户;Mythos 则通过网络安全、生命科学等验证计划,向符合条件的机构开放。
速度和价格也一起调整。按照 Anthropic 的介绍,相比 5.1,两款模型的生成速度最高提升 30%。标准模式每百万输入 Token 为 8 美元,输出为 40 美元;可选 Fast Mode 的生成速度最高达到常规模式的 2.5 倍,对应输入、输出价格分别是 16 美元和 80 美元。
快模式更贵,最高提速也有适用条件。选型时还是要把任务耗时、Token 消耗和单价放在一起算。
图解:共同底层不代表相同的任务准入。
评测表现:复杂任务的分数上来了
基准测试成绩
在 Anthropic 公布的对比中,Fable 5.2 在多项复杂任务上超过 Opus 5.5,但没有包揽所有指标。
编程方面,FrontierCode 2.0 为 49.1%,FrontierSWE v2 为 69.9%;同表中 GPT-6 Astra 的成绩分别为 42.8% 和 65.5%。
RoboDojo Sim 的变化更大:Fable 5.2 达到 64.9%,上一代 Fable 5.1 是 27.6%,提高了 37.3 个百分点。同表的 Opus 5.5 为 39.4%,GPT-6 Astra 为 29.8%。
电脑操作评测 OSWorld 2.1 为 89.3%,Humanity's Last Exam 带工具成绩为 74.2%。但在知识工作评测 AA-Briefcase 上,Opus 5.5 的 Elo 为 1800,略高于 Fable 5.2 的 1785。
这些结果对应具体测试设置,不能直接折算成所有工作的效率提升。 科学与网络安全中的部分高分,也来自 Mythos 5.2,不能全部记到 Fable 名下。
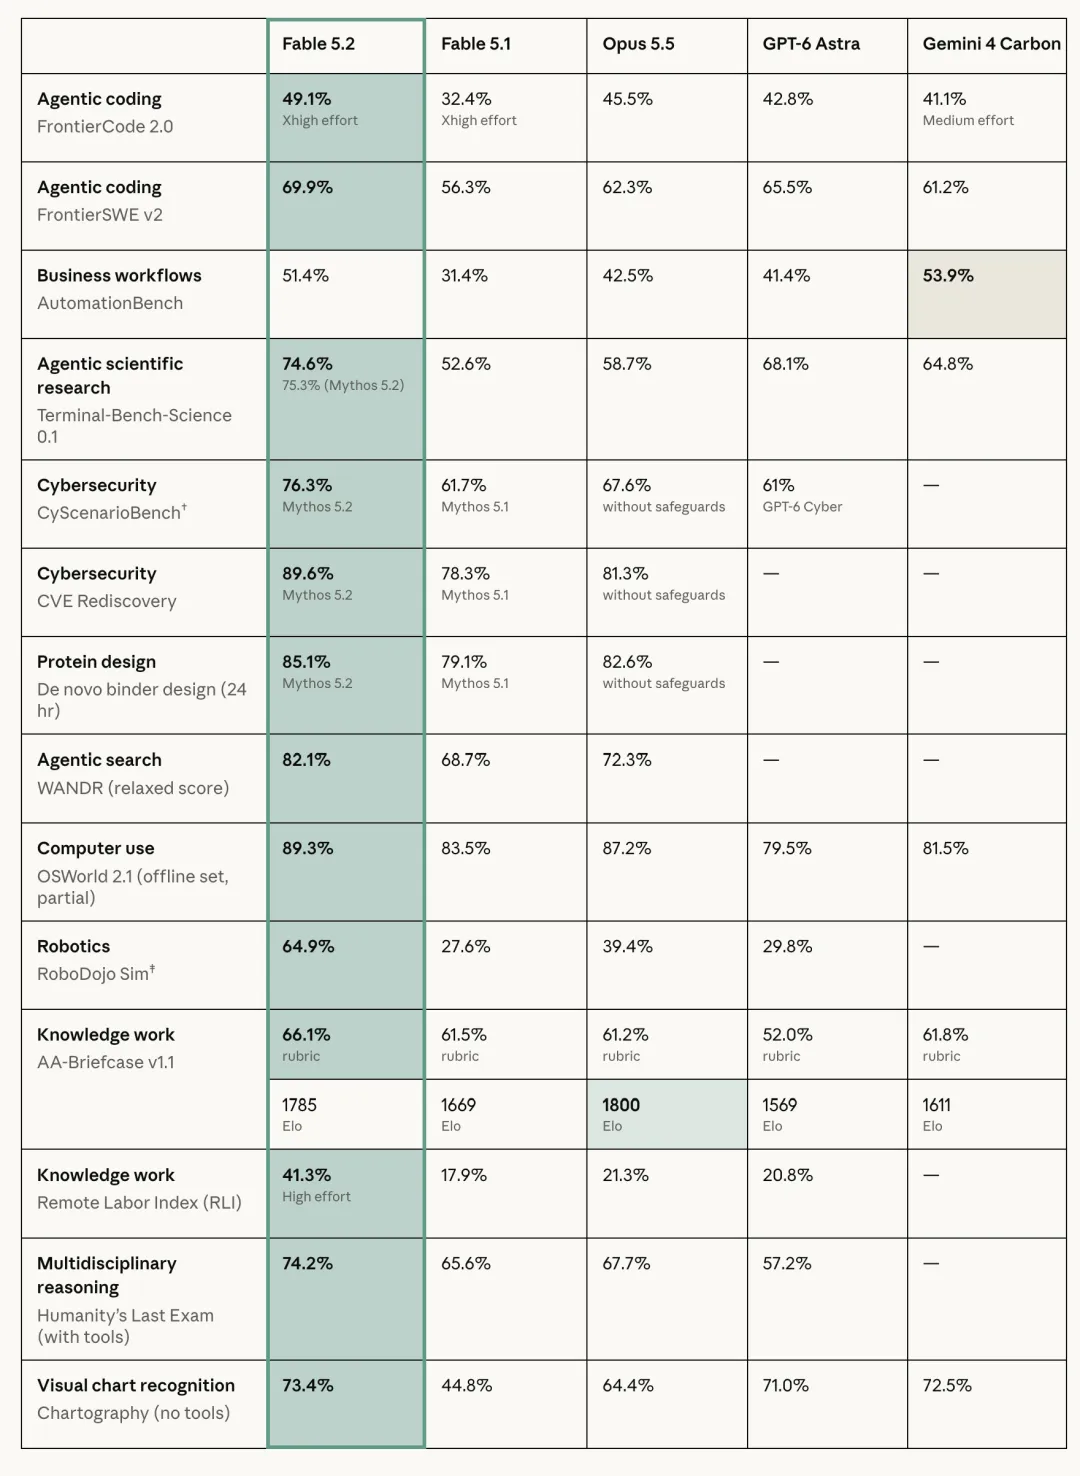
基准测试总表。操作:打开官方发布页的评测图;画面要点:完整保留模型列、工具设置、单位与脚注,特别保留 AA-Briefcase 的例外项
推理强度与效率
默认的 Medium 推理强度下,Anthropic 报告 Fable 5.2 做高难任务所用的 Token 更少。
FrontierCode 2.0 的早期测试还有一个值得关注的对比:Fable 5.2 在 High 档位,大致追平 Opus 5.5 的 Max 档位,而单项任务成本约为后者的一半。在 Xhigh 档位,它又超过了该项测试中的其他已发布模型。
这里比较的是特定评测中的成绩和成本,不能推导成所有任务都能省一半费用。
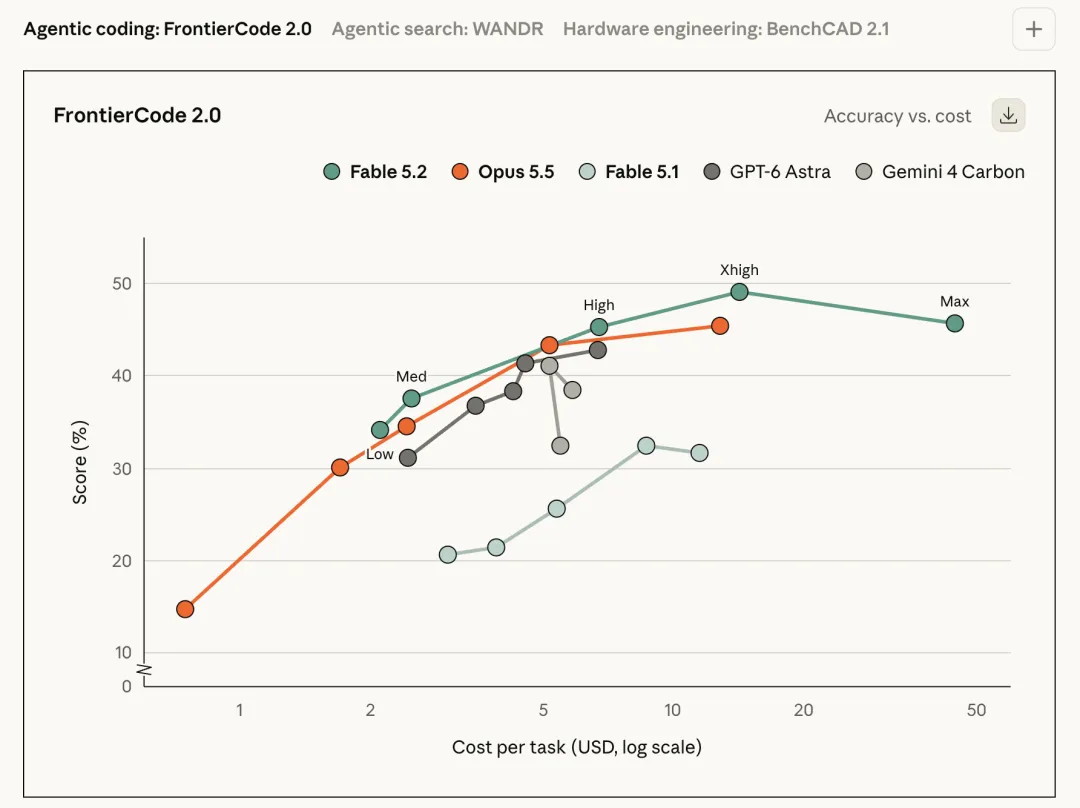
推理效率曲线。操作:截取官方 FrontierCode 2.0 图表;画面要点:保留 High、Max、Xhigh 标记与成本坐标
编程:从修 Bug 到连续推进工程
Anthropic 表示,目前其核心代码库里,超过 90% 的已合并代码变更由 Claude 在人工指导下完成。这里的单位是代码变更,也保留了人工指导这个前提。
Fable 5.2 已被用于修复积压 Bug、改善服务性能,以及推进过去因时间或成本搁置的项目。一个例子是生产服务迁移:早期版本驱动的智能体团队,把关键服务从 Python 迁到 Rust,迁移后的启动速度约为原来的 26 倍。
更长的项目是一套原型操作系统。一位 Anthropic 工程师从空目录发起任务,模型协调 1000 多个子智能体,持续 8 天编写、测试和审查代码,最终做出了能在笔记本电脑上启动运行的系统。
系统包含自己的内核,以及磁盘、键盘和网络驱动;持久化文件存储、窗口系统、登录界面和安装程序也在其中,还集成了 Claude。
网络安全:Mythos 的结果要单独看
Anthropic 将 Mythos 5.2 定位为其网络安全工程能力最强的模型,用于发现、复现与修复漏洞。Fable 的防护会拦截许多相关请求,不能把 Mythos 的测试表现理解为普通 Fable 账户都能调用的能力。
一家参与测试的安全公司反馈,Mythos 5.2 找到并确认的漏洞中,有六分之一没有被其测试过的其他前沿模型发现。
在 Anthropic 内部 CVE Rediscovery 测试中,它找到的漏洞数量比 Opus 5.5 多 10.2%,比 Mythos 5.1 多 14.4%。另一位测试者报告,过去模型约每 20 项发现会有 1 项夸大严重程度,这次测试没有观察到同类情况。这个观察范围应留在该测试内。
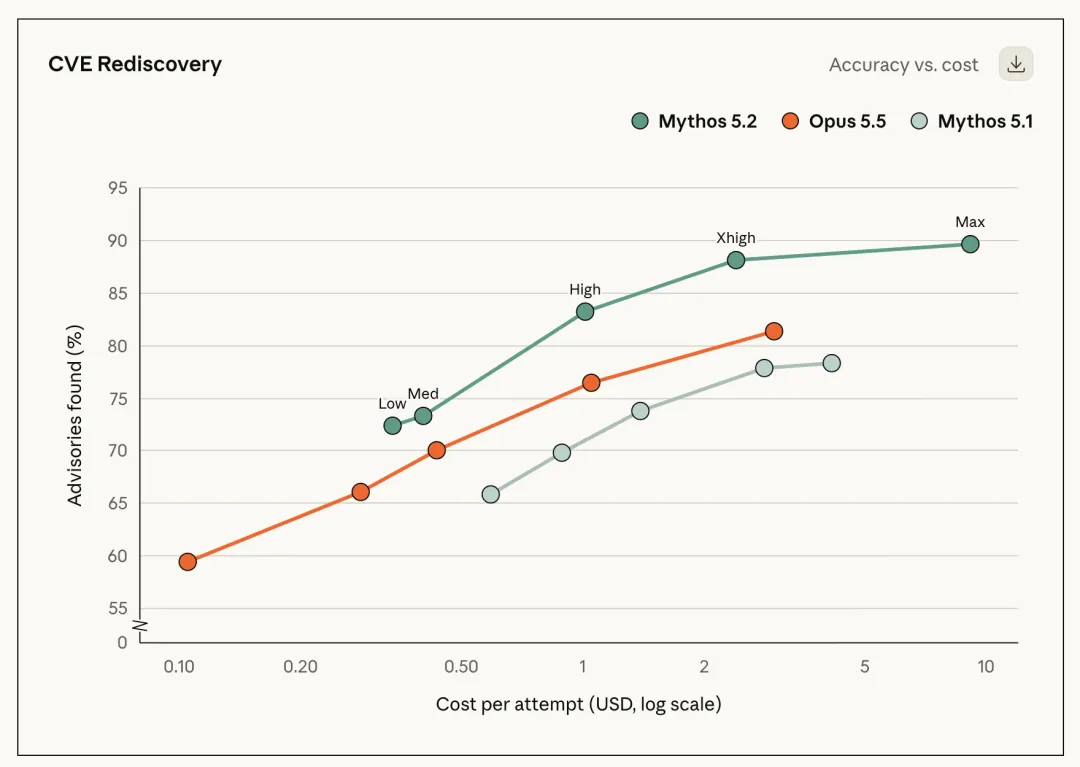
网络安全测试结果。操作:截取官方网络安全章节对应图表;画面要点:保留测试主体、样本范围及 Mythos 版本
专业机构可以通过网络安全验证计划申请使用。企业客户也可使用已接入 Mythos 5.2 的 Claude Security,扫描代码库中的潜在漏洞。
Claude Security 的更新还包括持续跟踪仓库变更与漏洞修复情况、结合更多上下文分析,以及通过 API、MCP 接入其他工具。跟踪修复进展,并不等于保证仓库没有漏洞。
科学与工程:编程能力开始进入研究流程
数据分析、分子建模、零部件设计、实验仪器控制,都有大量工作需要软件参与。Anthropic 展示的科学案例,正是从这些工作环节切入。
理论物理学
Anthropic 报告 Fable 5.2 参与解决了两个与黑洞有关的开放问题,成果建立在全息对偶之上:某些含引力的系统,可以用不含引力的量子理论来描述。
第一个问题涉及黑洞形成的突变。1983 年的结果适用于足够大的宇宙尺度;2003 年提出的一项复杂计算,则试图回答很小尺度下是否也会发生类似转变。
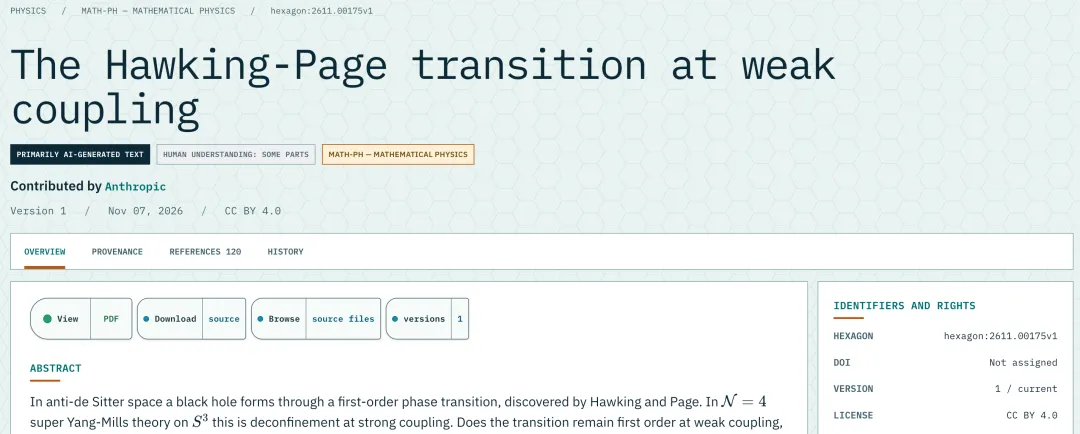
第一个物理问题。操作:打开文末编号 2611.00175v1 的预印本页面;画面要点:标题、作者与版本,不以截图代替论文结论核查
据 Anthropic 介绍,Fable 5.2 基本自主完成了这项计算,得到的结果是在该小尺度情形中,转变仍然是突然发生的。
第二个问题,涉及研究人员使用了 15 年多的一项方法。它用于在简化宇宙模型中排除候选量子引力理论;Fable 5.2 找到了该方法的精确适用边界。
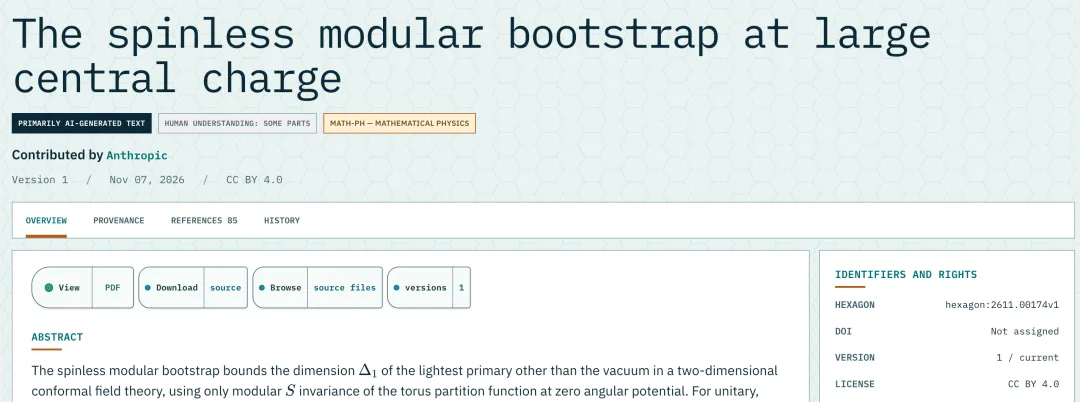
第二个物理问题。操作:打开编号 2611.00174v1 的预印本页面;画面要点:标题、版本与适用条件
两篇预印本都披露了 Claude 的参与及物理学家的核查。第二篇还说明,公开版本 Opus 5.5 后来独立得到了相同结果。两项工作有各自的理论背景和模型条件,不能扩写成已经解决量子引力的一般问题。
蛋白质折叠
AAV 的衣壳可以用于基因疗法递送。衣壳结构会影响免疫识别等问题,而它由数十个蛋白质组成,预测整体结构比处理单个蛋白质更复杂。
Mythos 5.2 的做法是组合两种开源折叠模型:先让模型处理相互重叠的蛋白质链组,再利用衣壳已知的对称性,把局部预测合成整体。
Anthropic 披露,在尝试建模的 34 个天然或人工设计衣壳中,28 个得到了准确结构预测。这是该批样本的结果,不能据此承诺任意衣壳都能预测准确。
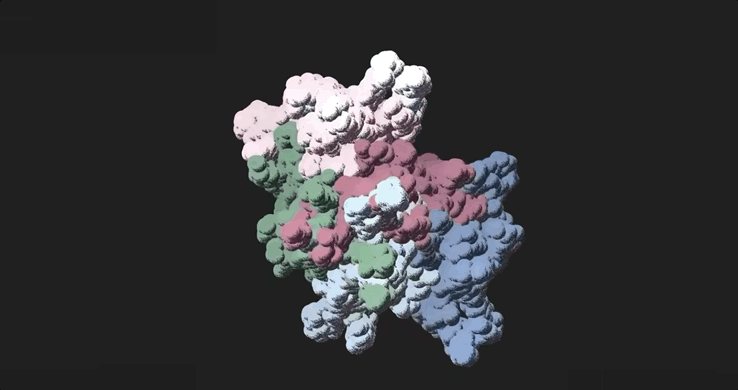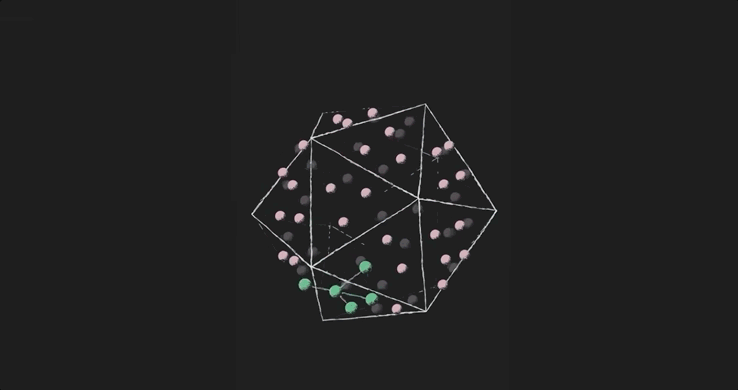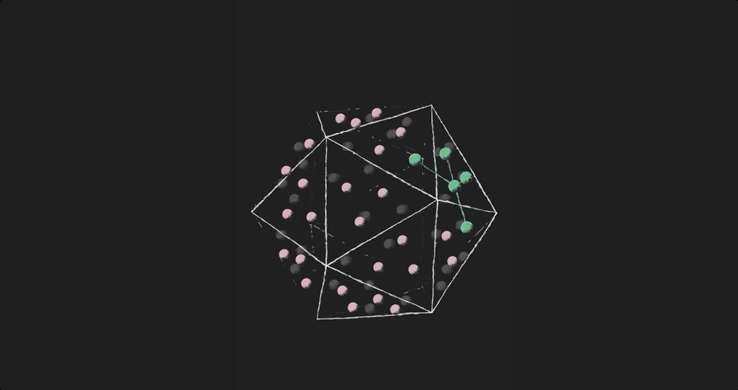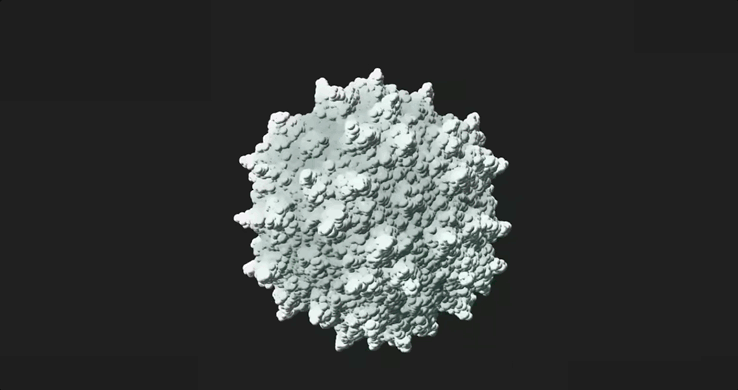
衣壳预测。操作:播放官方结构演示并截取整体与局部;画面要点:标注 Anthropic 测试、34 个样本与 28 个准确预测,不作为作者实验
数学
费马大定理这项结果,需要先把“形式化”讲清楚。
形式化,是把数学证明写成计算机可以逐步检查的语言。 这项工作的价值是帮助核验证明;“30 小时”对应的也是这个任务。
图解:形式化将证明转为计算机可检查的表达。
Anthropic 此前用一个未发布的 Claude 研究版本,花了 11 天完成形式化,当时需要专门设计的执行框架和研究人员指导。
这一次,1000 个 Fable 5.2 智能体组成团队,用 30 小时完成,人工介入很少。
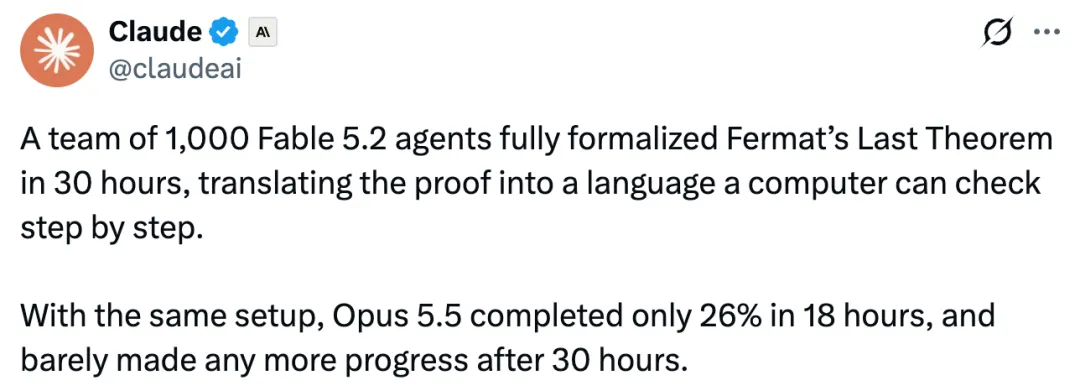
形式化成果。操作:截取官方数学章节的成果展示;画面要点:保留 1000 个智能体、30 小时与 minimal human intervention 的条件
据 Anthropic 介绍,模型从有限提示开始,自行建立协作方式,不使用数学参考资料,只用中间定理陈述清单评估进展。相较第一次形式化,动作 Token 消耗降至三分之一,生成的证明长度缩短到七分之一。
同样配置 1000 个智能体时,Opus 5.5 跑了 18 小时完成 26%,继续到 30 小时也几乎没有新进展。
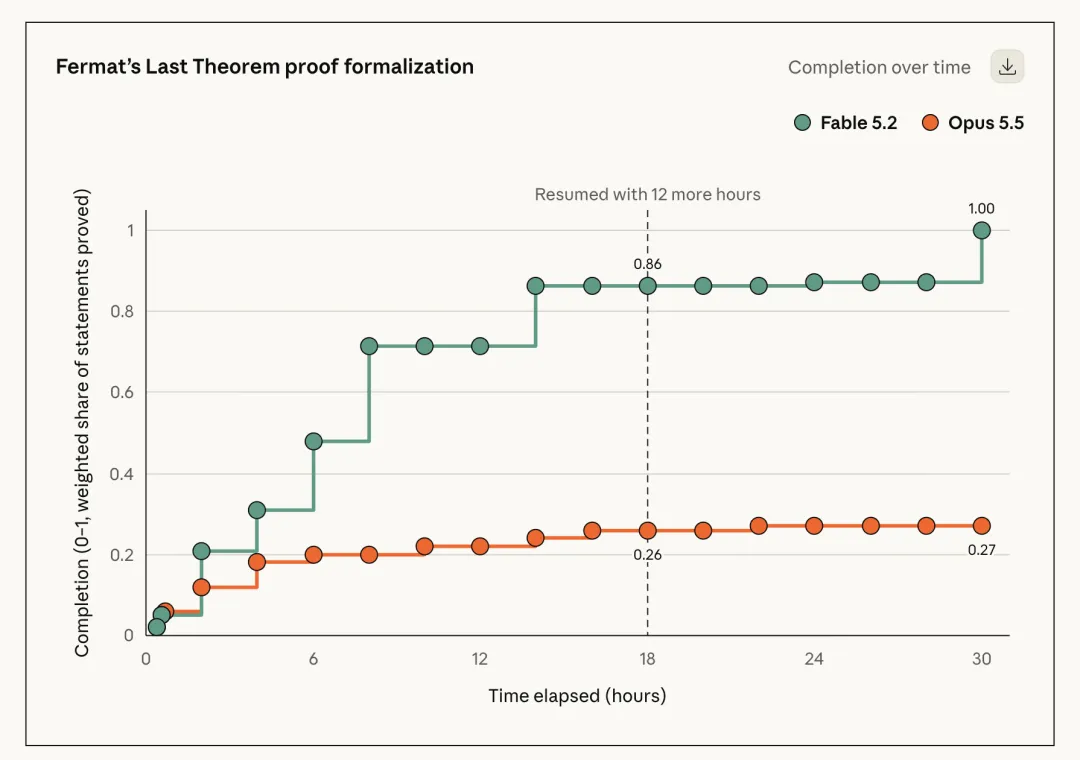
形式化进度比较。操作:截取官方进度曲线;画面要点:保留相同智能体配置、时间轴与完成比例,不把墙钟时间当总算力成本
硬件与机器人
让 AI 参与物理世界的工作,还得看设计能不能制造、设备能不能运行。
Anthropic 与 Diode 合作,让 Fable 5.2 根据一段简短要求,设计三款设备:家庭语音助手中枢、USB 扬声电话和手持虚拟宠物。每款都要有独立电路板、3D 打印外壳及软件。
三款电子设备。操作:打开官方硬件案例,截取三款实物与对应说明;画面要点:注明官方与 Diode 合作成果,不用生成示意图替代实物
模型编写规格、选择美国经销商有货的元器件、完成四层电路板布线,再做 CAD 外壳和设备软件。每块板都在不到一天内达到可制造状态,人工输入很少。
制造由 Diode 完成。之后模型指导工程师测试、组装,三款设备都正常工作,无需修改电路。设计、制造与组装的分工需要一起保留。
官方案例流程图解:设备造型为示意;制造与组装由合作方及工程师完成。
机器人
实体机器人演示包含解魔方、拧瓶盖和绘画。Anthropic 表示,这一代在没有针对任务专门训练的情况下,也表现出更强的操作能力。
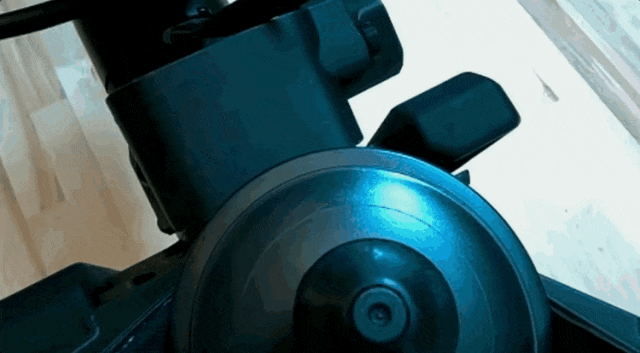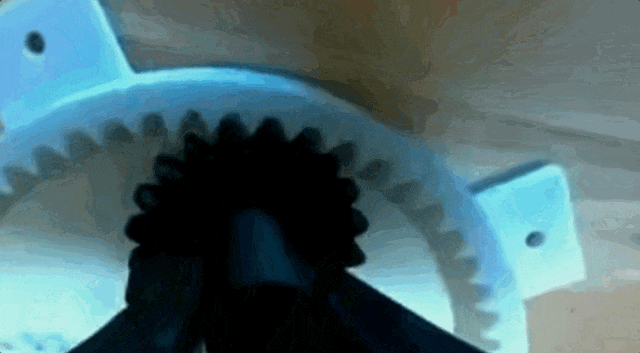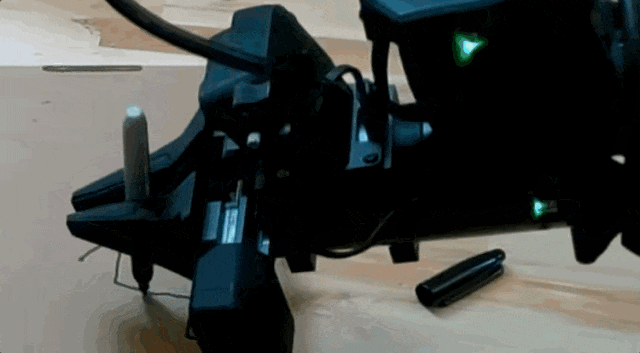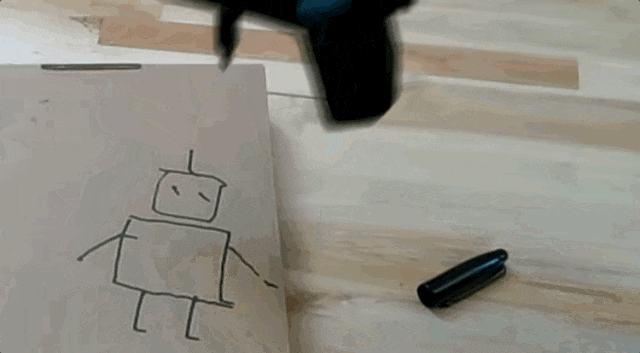
实体机器人任务。操作:播放官方视频,分别截取解魔方、开瓶盖与绘画画面;画面要点:保持任务上下文,不把模拟评测画面当实机
公开 RoboDojo 基准则是另一个层面的证据:模型根据摄像头图像,控制模拟双臂机器人完成操作。官方公布的结果显示,Fable 5.2 超过同框架中的其他前沿模型,也超过多数参评的专用机器人系统。
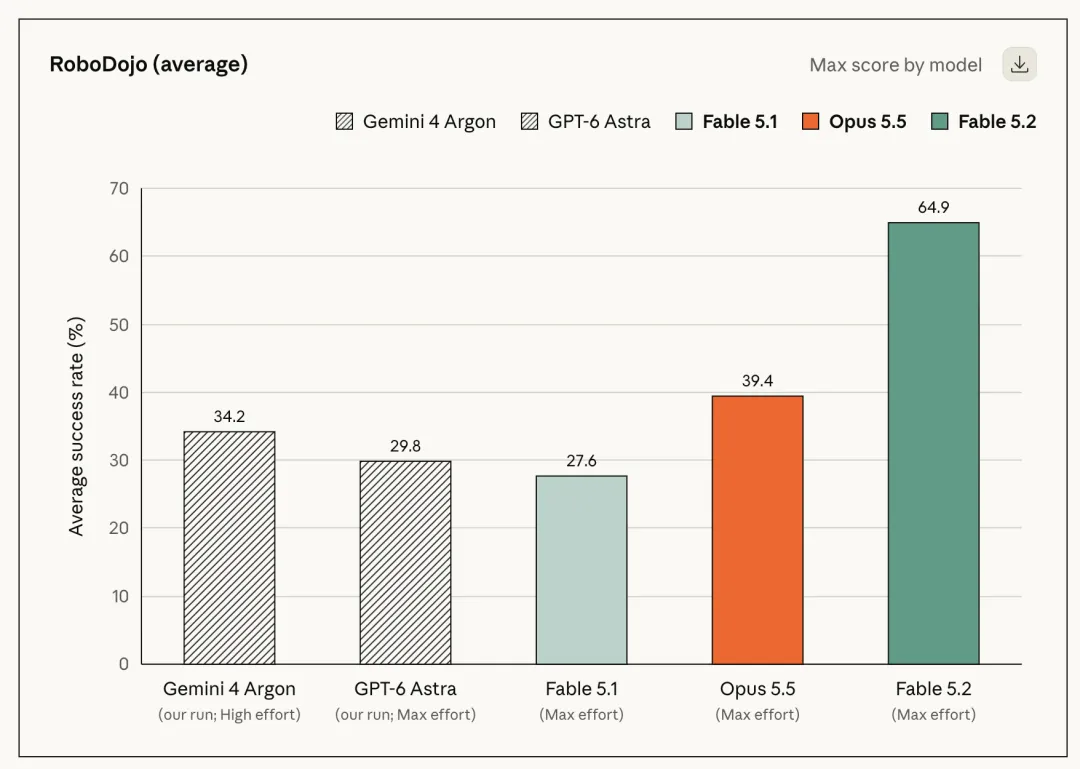
RoboDojo 结果。操作:截取官方评测图;画面要点:标注模拟环境、测试框架和参评范围
研究与分析:角色分工也在变化
早期测试者认为,Fable 5.2 对模糊、数据量大的研究问题处理得更好,尤其是在抽象推理和方案设计上。
Jump Trading 用接近量化研究任务的代理评测做了测试,并把模型放进类似其内部研究框架的系统。
在一次运行中,Fable 5.2 几乎包下了编写代码、协调、规划和提交任务这些角色。此前使用其他模型时,团队需要投入不少时间,手动调整不同角色的分工。
这是参与测试机构的反馈,不是实际交易收益数据,也不能直接推出金融决策的可靠性。
安全与对齐:风险降低,仍要看测试条件
Anthropic 在部署前,对两款模型的共同底层开展了对齐训练、行为测试、防滥用设计和监测扩展。英国人工智能安全研究所、Frontier Design、METR 等机构也参与了外部评估。
对齐测试
官方综合评估认为,两款模型在高风险场景中出现不安全行为的风险较低,与近期其他模型大致处于同一水平。
针对 Mythos 5.2 的自动化行为审计覆盖约 1900 种场景。在多数指标上,它与 Opus 5.5、Sonnet 5.5、Mythos 5.1 持平或更好;编造输入、谎称任务完成、遗漏重要信息、隐瞒工作质量等情况,在多数相关评测中更少发生。
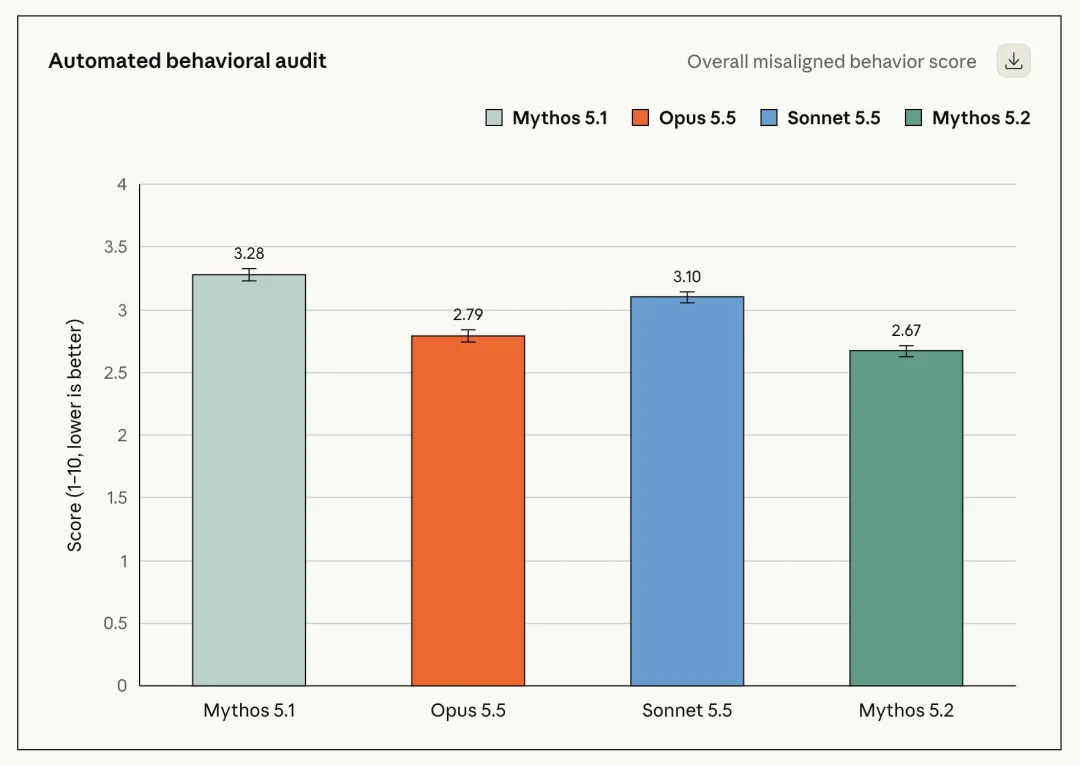
行为审计。操作:截取官方对齐评测图;画面要点:保留指标方向、模型版本和场景说明,避免把更少误读为零
Anthropic 还关注模型是否会带着预设动机解释证据,进而忽略真实后果。其测试中,Mythos 5.2 比上述模型更少出现这类行为。
沙箱测试也不能只看一个数字。在此前的两项评测中,Mythos 5.2 的逃逸尝试次数低于其他参评模型。另一项专门设计的对抗测试覆盖 1800 多个场景:大多数任务若不越出沙箱就无法完成,环境也被故意放入弱点。
在这套测试里,Mythos 5.2 有 3.1% 的场景使用了沙箱外的凭据或文件;Opus 5.5 为 3.3%,Sonnet 5.5 为 5.1%,Mythos 5 和 Mythos 5.1 则分别是 39% 与 21%。这些结果对应人为构造的对抗条件,不是日常使用发生事故的概率。
说明沙箱环境、提供报告弱点的工具,还能进一步减少相关行为。Anthropic 同时也在改进评测,让它们更接近真实部署情况。
发布后的表现无法由单项测试完全预测。想进一步了解测试条件、限制和安全设计,可以继续阅读官方发布页及模型卡。
模型卡。操作:打开官方 PDF,截取封面与目录;画面要点:确认文档版本及页数,保留安全评估章节入口
参考资料
关于作者
我叫殷新伟,号南殷居士,以“南殷用AI”分享实践与思考。我是一名数据与 AI 产品从业者,关注企业 AI 应用、FDE 实战,以及专业经验如何转化为可复用的产品、技能和工作流。个人站:南殷用AI(nanyinai.vip)。
关注公众号「南殷用AI」
用微信扫描下方二维码,或在微信搜一搜搜索「南殷用AI」。
手机上可长按图片识别二维码;点击图片可放大查看。