实测 OXR,1.3B 小模型让我重新看待文档解析
几百份产品手册、企业标准都放进知识库了,AI 回答起来却还是张冠李戴。碰到这种情况,我会先往前查一步:它到底读到了什么?
PDF 里的字识别错了,表格的行列串了,注释混进正文,再强的模型也得拿着这些材料往下答。解析不是知识库出错的唯一原因,但它是绕不过去的一关。
这次我试的 OXR,就在解决这个问题。SoMark 团队把它做成了一个 1.3B 参数的文档解析模型:输入 PDF 或文档图片,输出方便 Agent 使用的 Markdown、JSON,以及版面坐标。
OCR 是 Optical Character Recognition。OXR 把 Character 换成 Everything,想处理的显然不只是文字。
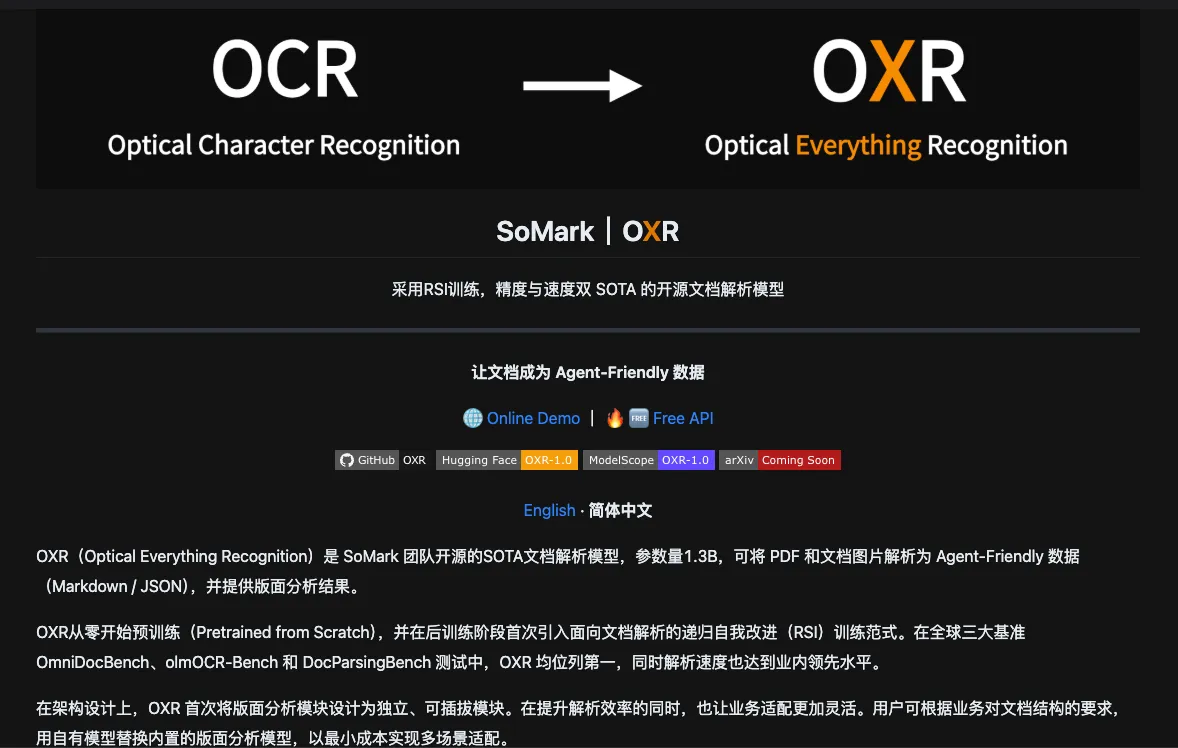
OXR 官方介绍与解析演示(两张)

OXR 文档解析动态演示
官方发布页的日期是 2026 年 10 月 20 日。发布之后海外热度来得很快。Daily News 把 OXR 放上了头条,同话题 225 条帖子; 开源一周 GitHub 已经攒了 1.1K+ star。对一个 1.3B 的小模型来说,这个热度非常恐怖了,从发布到被海外媒体盯上,前后不到一天,速度甚至快过很多大模型发布。
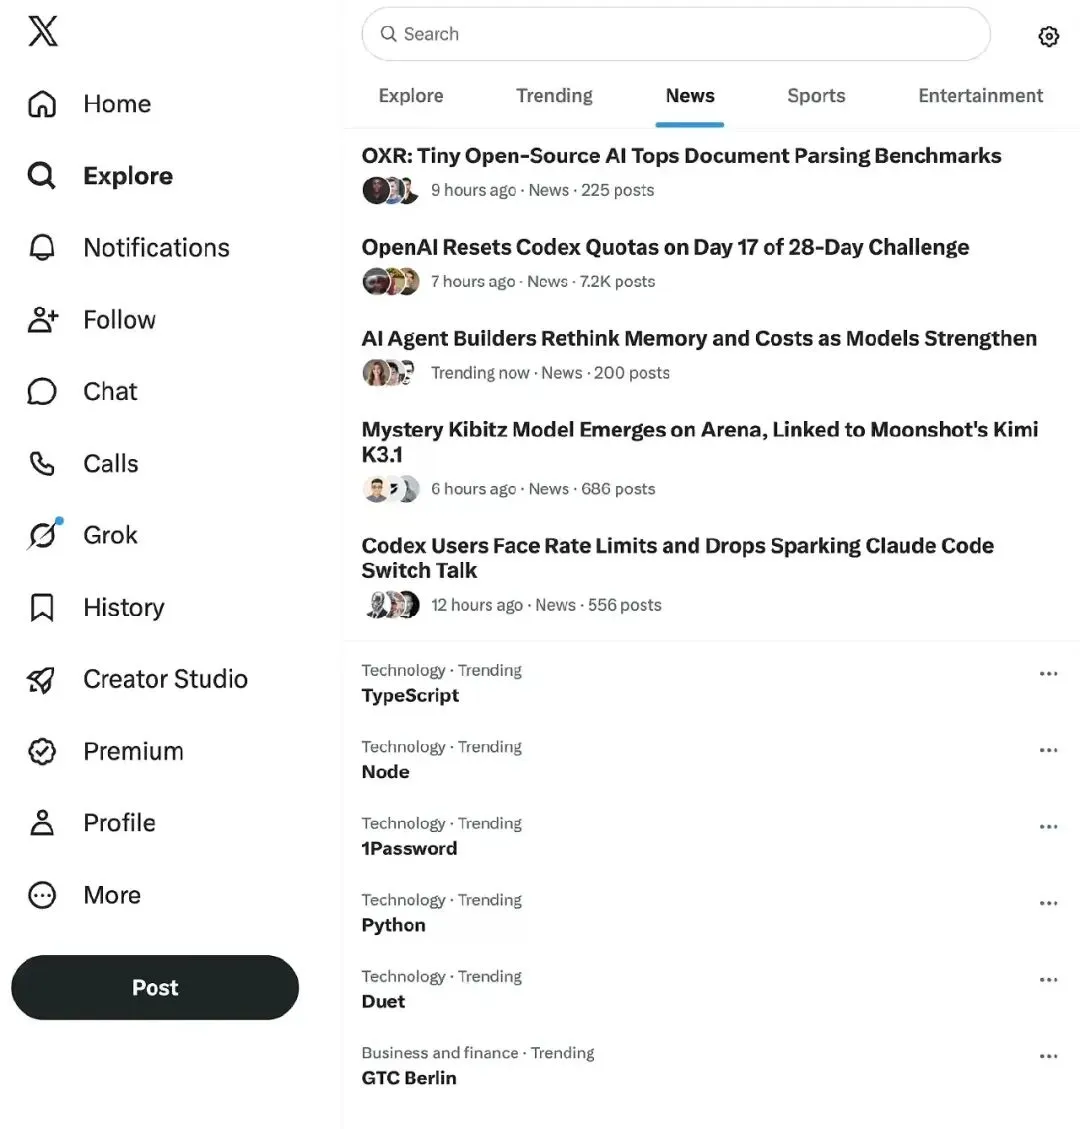
发布与开发者讨论
实测
先看它为什么值得试。
PaddleOCR-VL-1.6、MinerU2.5-Pro、OvisOCR2,这个方向已经有不少选手。SoMark 公布的对比里,OXR 在 olmOCR-Bench、OmniDocBench、DocParsingBench 三项综合成绩上排在所列模型首位。这里说的是官方公布的对比快照,准确率快照日期为 2026 年 10 月 5 日,不是一个永远有效的“全球第一”。官方评测说明(https://github.com/SoMarkAI/OXR/blob/main/docs/benchmark.md)
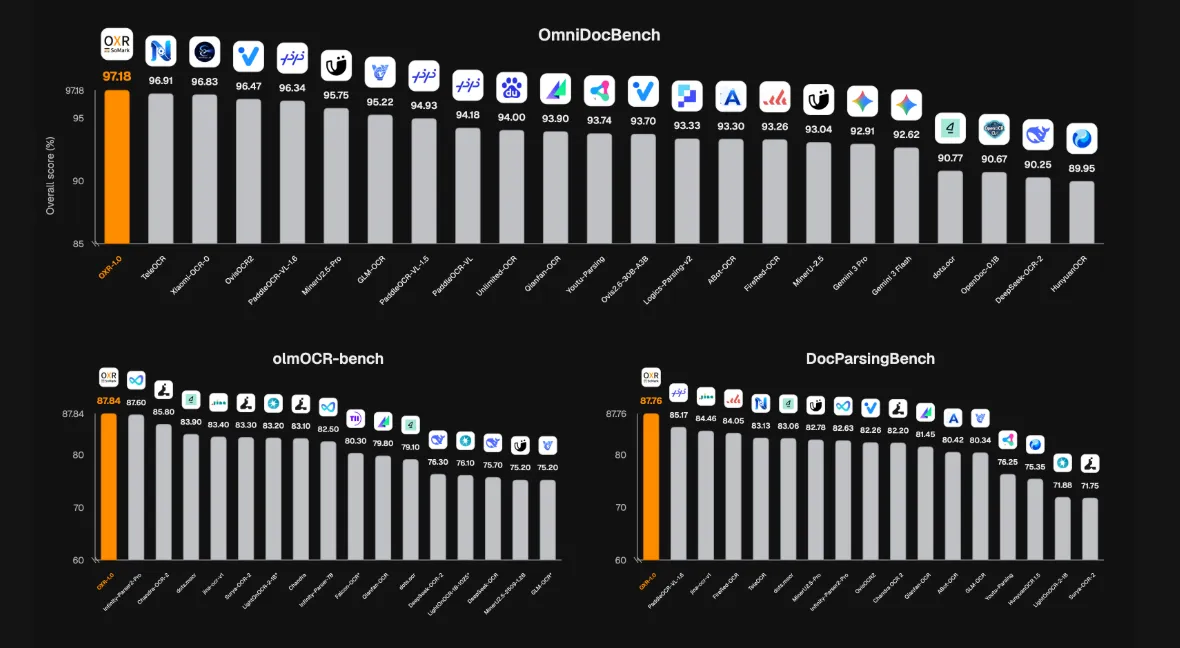
三项评测对比
官方列出的识别对象有 13 类,公式、表格、化学方程式、化学结构式、代码块都在里面,还能返回对应区域的位置。能力与输出说明(https://github.com/SoMarkAI/OXR/blob/main/README_CN.md)
对知识库来说,认出文字只是起点,保住结构才更有用。
我先放进去一份高中化学试卷。
这页的难点不在字多,而在内容混杂:题干之外,还有公式、表格和化学表达。解析后,主要内容能对应上,结构也保留了下来。
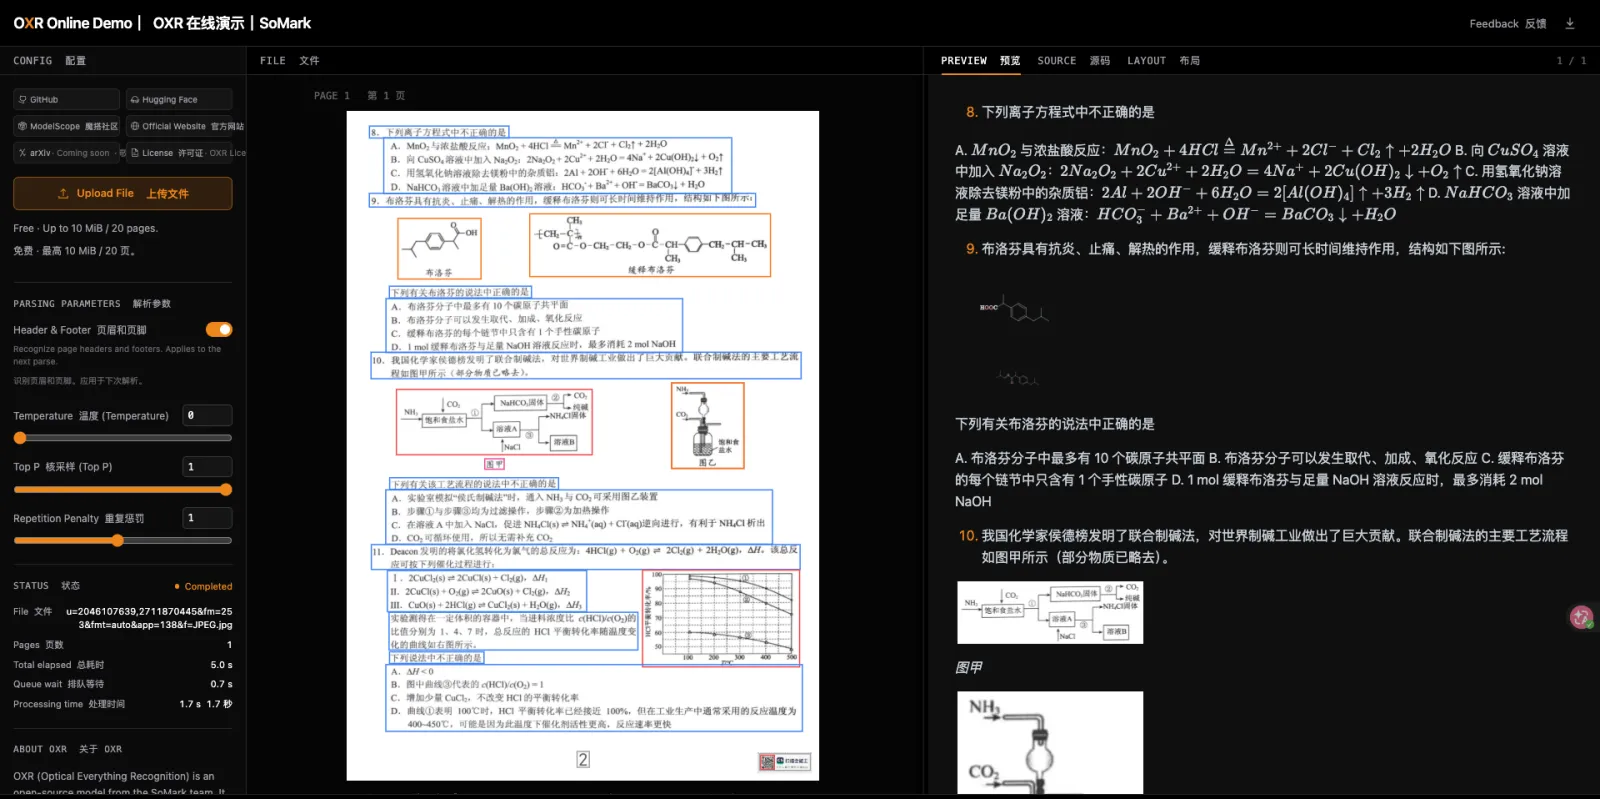
化学试卷输入与解析结果
我更关心的是下载后拿到什么。
这份结果的主体是 Markdown,表格用 HTML 表达,公式是 LaTeX,化学方程式用 mhchem,化学结构式用 SMILES。它不是把一页纸拍平为一段纯文本,而是尽量留下不同内容各自的表达方式。
这样交给后面的 AI,至少不必先猜“这一串到底是公式还是正文”。渲染端仍要支持相应语法,不能只看预览里像不像。
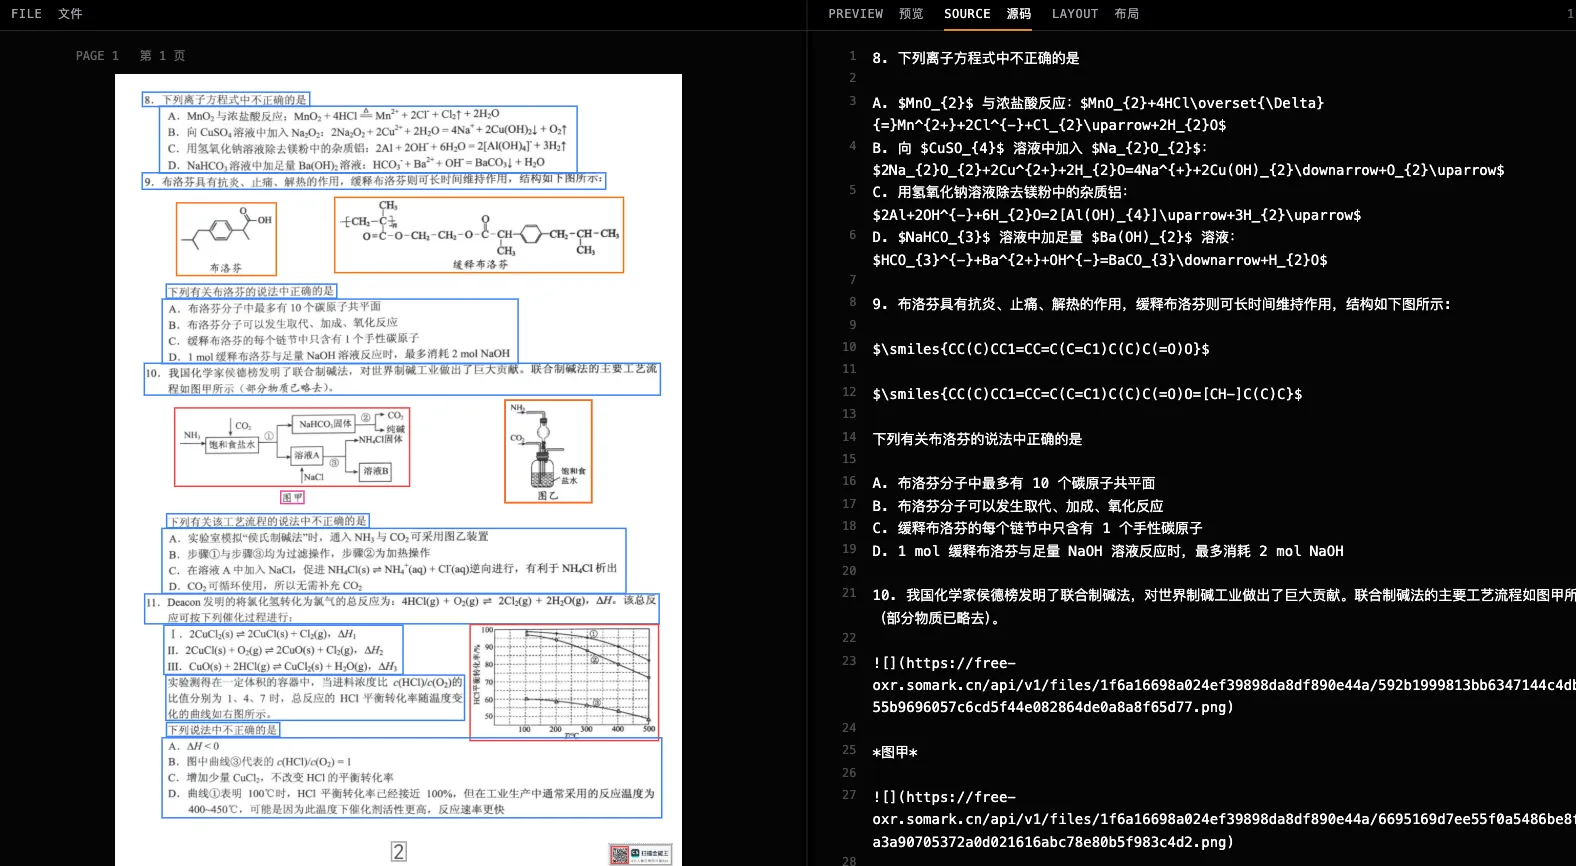
Markdown 源码与坐标
坐标也是我很在意的一项。拿到内容,再拿到它在页面上的位置,做原文回看、结果高亮就有了依据。它不等于知识库已经做好了,但能省掉一部分前处理工作。
第二份是一张虚构公司的利润表。
多级表头、合并单元格都放进去。表格识别最怕的不是漏一个字,而是字都对,金额却挂到了另一个项目下面。我对照了表头层级和数据归属,这张表的结构能对应上。
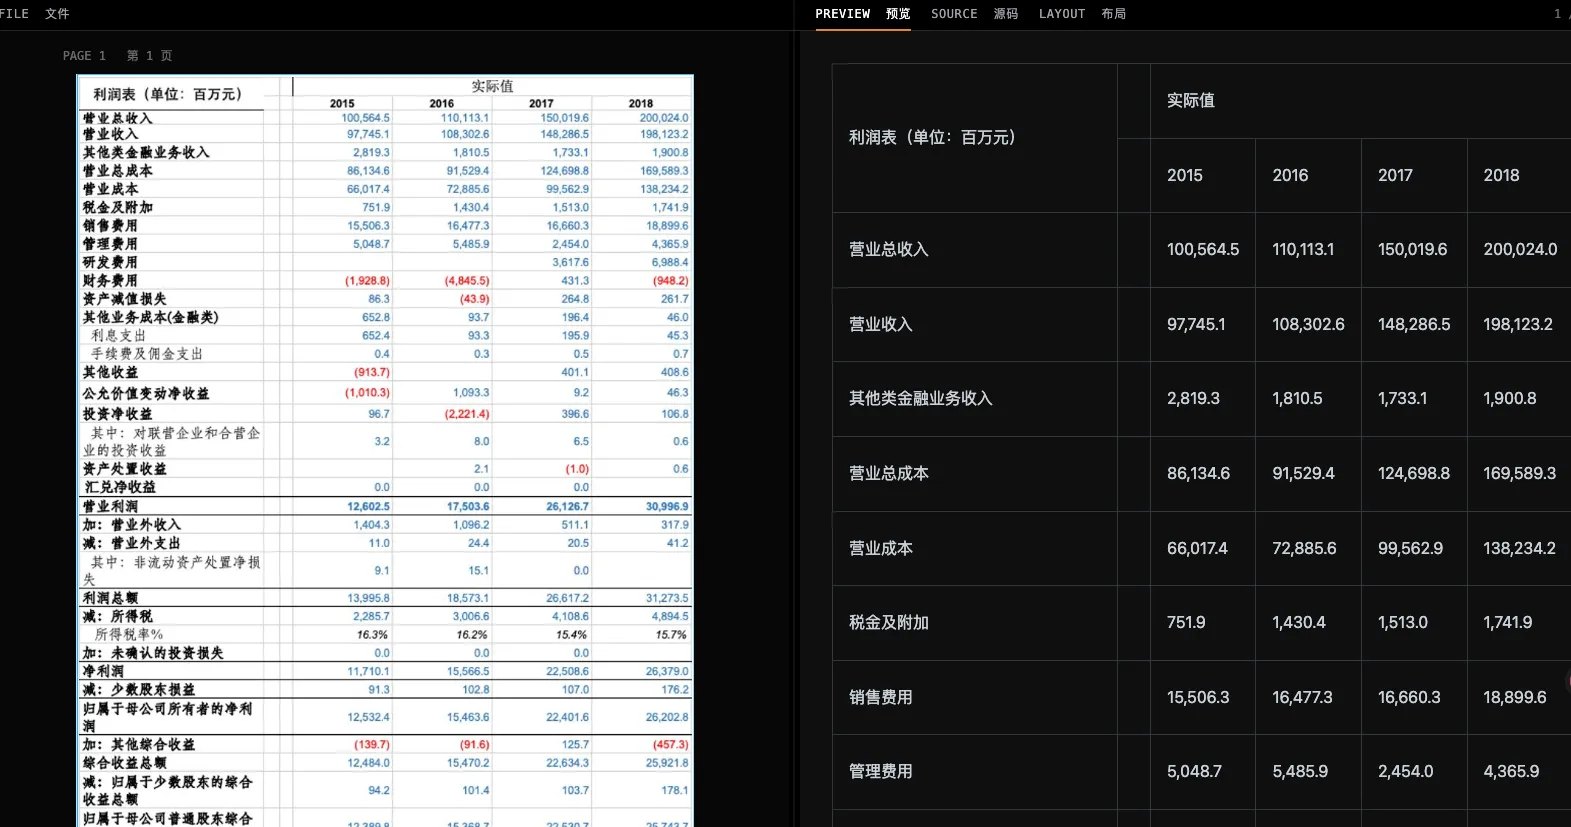
复杂利润表
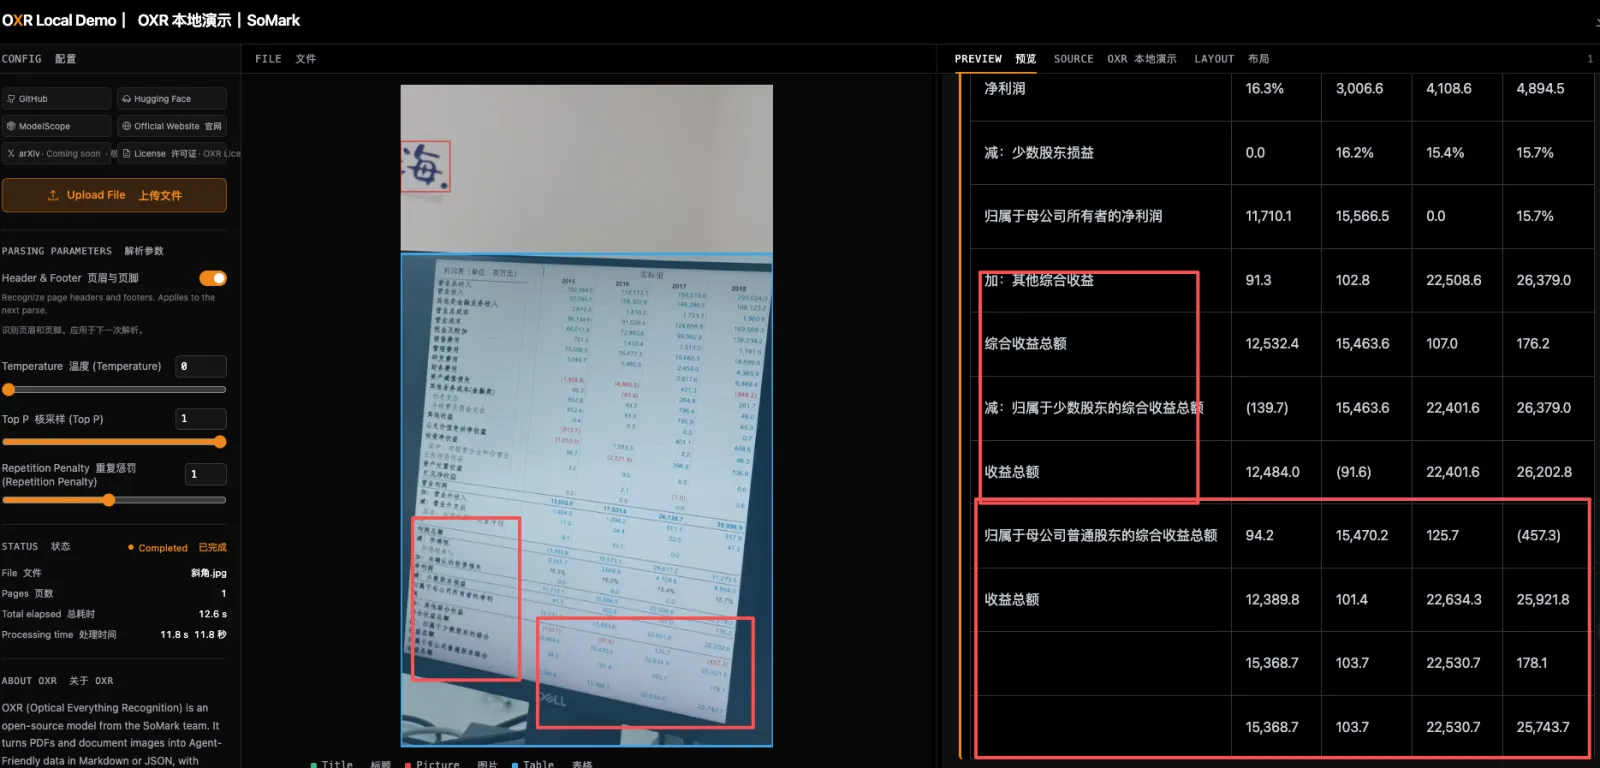
我又把同一份表格拍成手机照片,故意留了倾斜和阴影。结果的结构仍然保住了,没有因为换成照片就整张散掉。
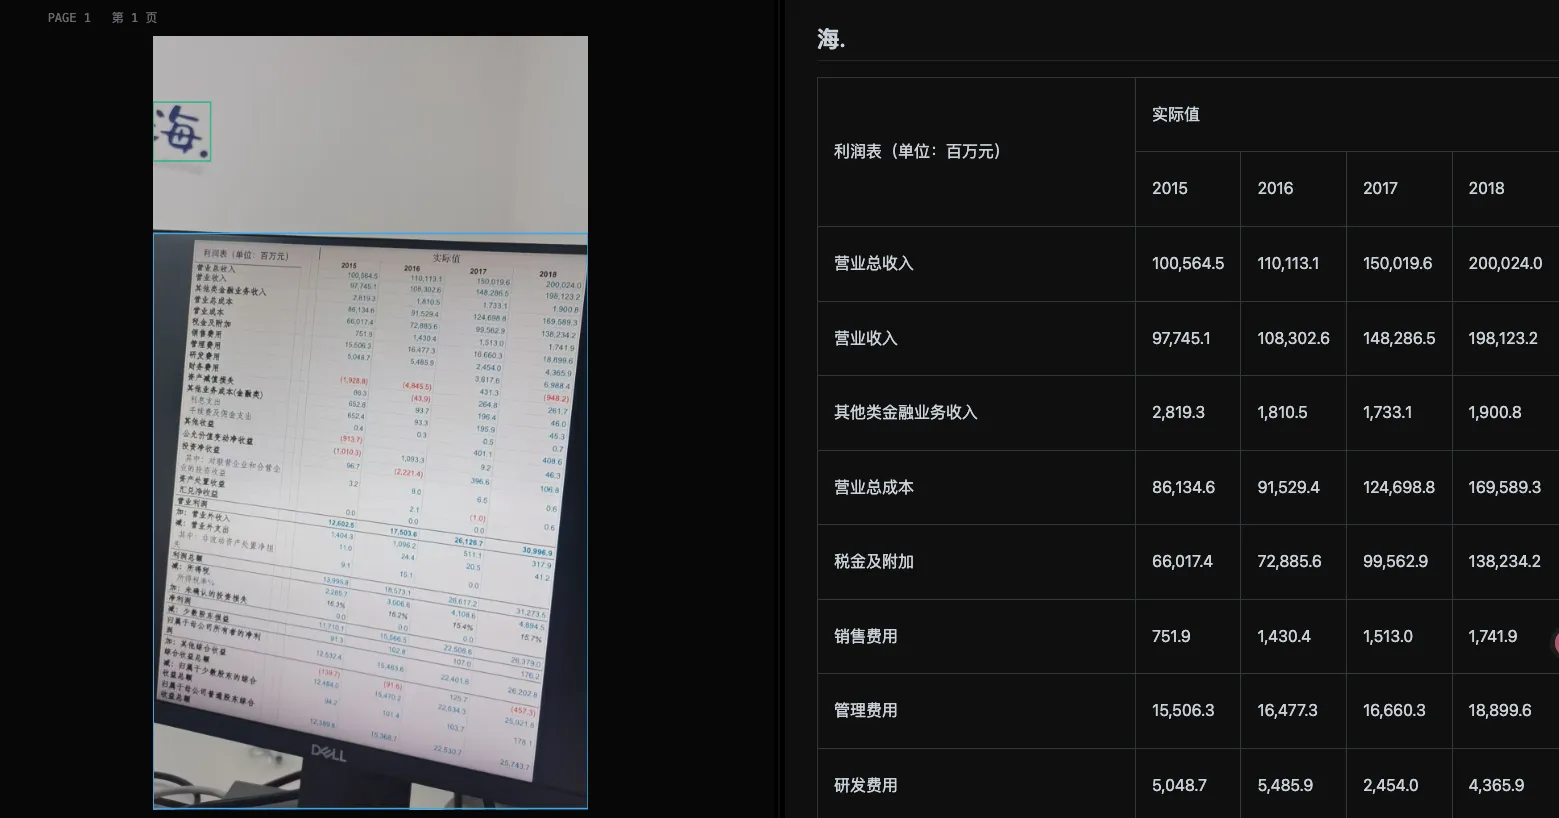
歪斜、带阴影的利润表照片
注意:但在设计单元格存在多行文字时 默认识别稍微会有错位偏差
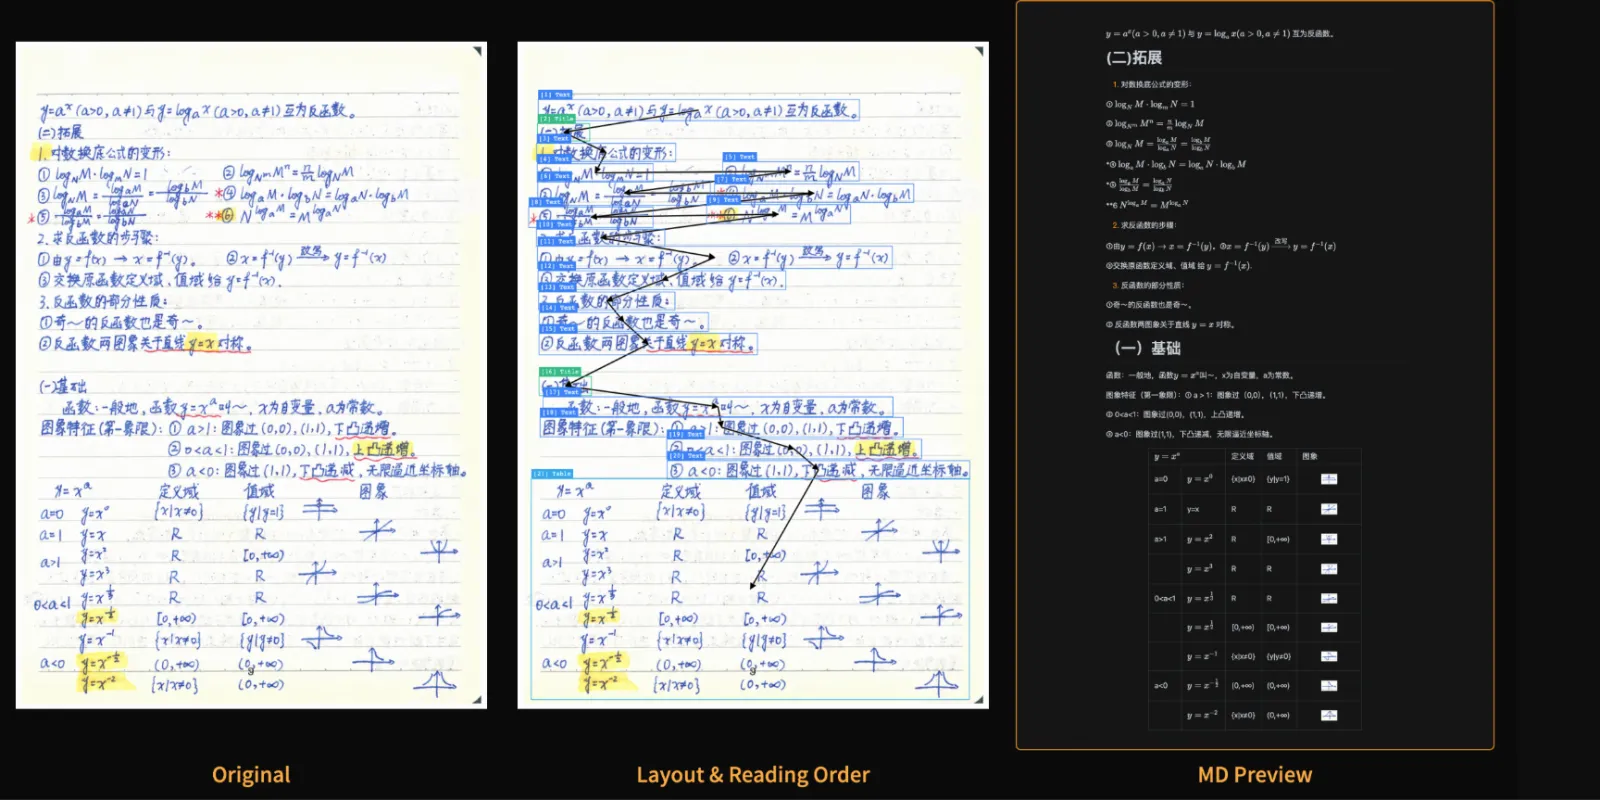
中文手写体这一项,我看的是 SoMark 的官方展示。展示中的识别结果与手写内容能对应上,这是官方样例的效果,不能直接推成任何人的手写字都能准确识别。
再看看研报的效果。
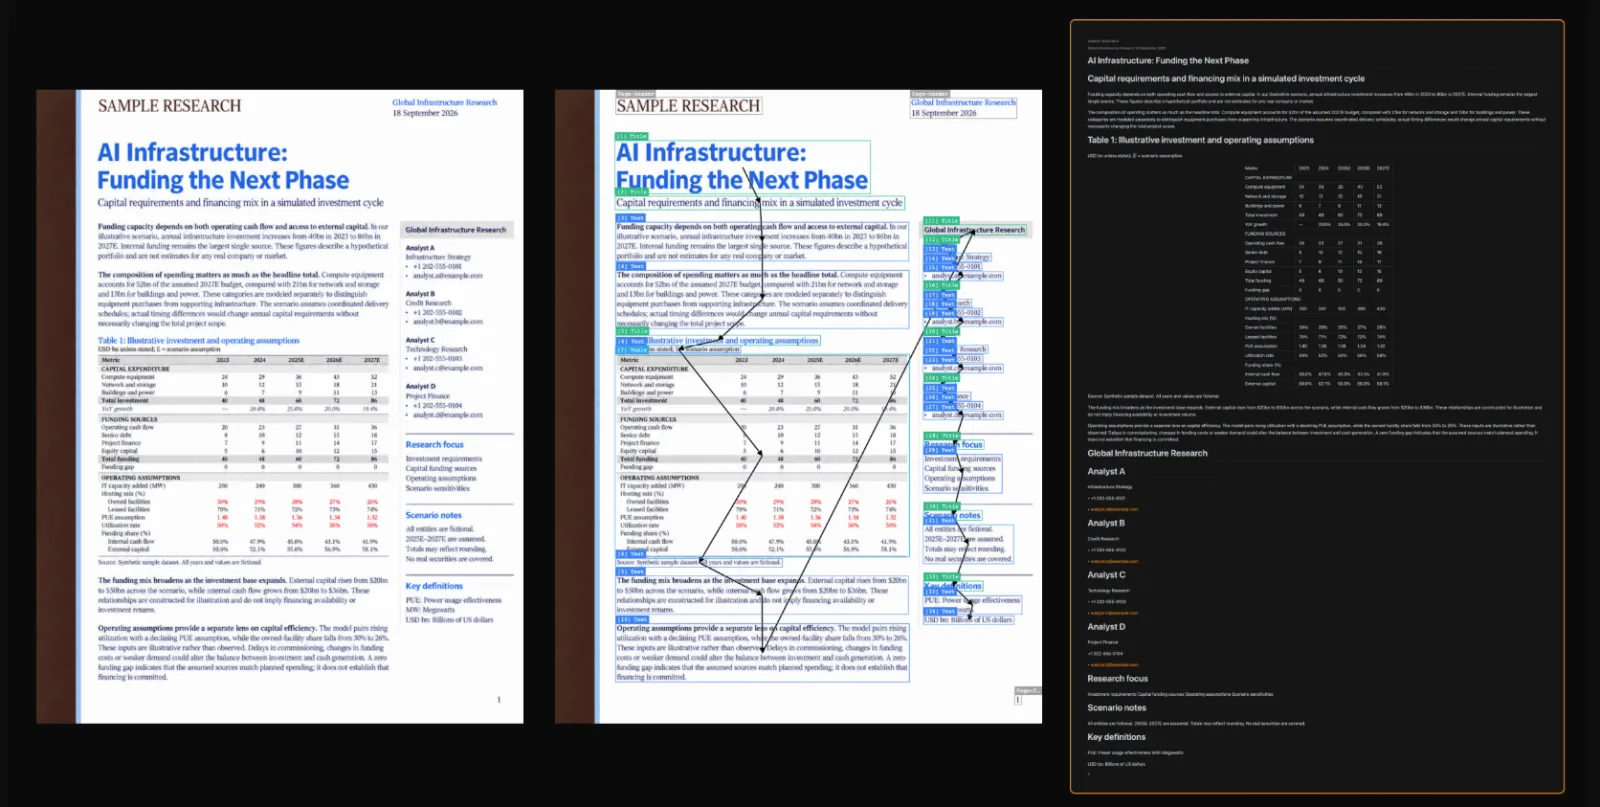
这些页面看下来,我对小模型的判断确实变了。参数量很小,不意味着只能处理简单任务。把任务收窄、把结构设计好,复杂文档也能做得很细。
速度方面,单页在线耗时会受排队、文件内容和服务状态影响,我更愿意看有明确条件的测试。
SoMark 的官方测速使用单张 NVIDIA RTX PRO 6000 Blackwell,从 OmniDocBench 固定抽取 100 页,在同一批页面上比较 21 个模型,端到端统计从输入到完成的时间。OXR 在这个对比中排名第一。它和页面上看到的单次耗时不是同一种测量,不能混在一起比。测速条件与结果(https://github.com/SoMarkAI/OXR/blob/main/docs/benchmark.md)
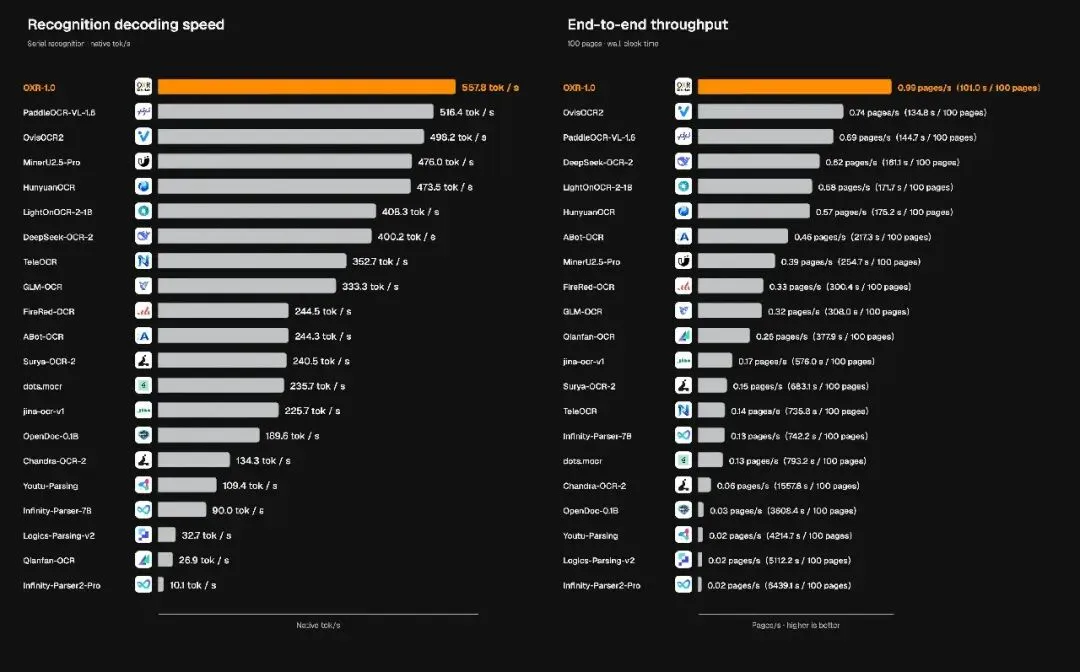
官方端到端测速
为什么能快?我沿着官方架构说明看了一遍,关键不只是 1.3B 这个数字。
常见的分阶段流程,要先分析版面,再识别文字、表格、公式,随后还得判断各区域的阅读顺序,把内容拼起来。步骤之间要传递结果,也会产生额外开销。
OXR 的拆法是:让一个独立的轻量模型负责版面分析,把内容识别和阅读顺序交给 OXR 一起处理。识别这块内容时,同时确定它该放在哪里。官方架构说明(https://github.com/SoMarkAI/OXR/blob/main/README_CN.md)
它没有把所有任务硬塞成一团,而是重新划了分工。
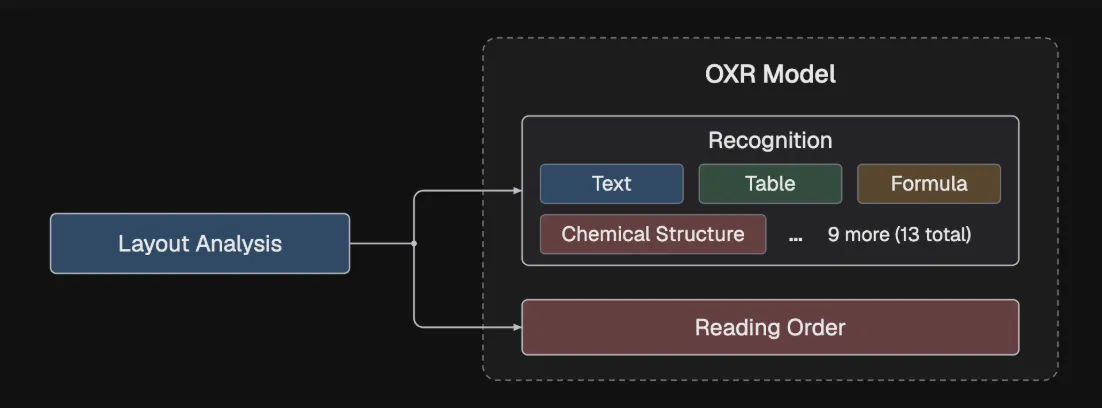
OXR 架构与任务分工
版面模块独立之后,还有个更实际的好处:可以换。
自带模型不适合自己的业务页面,就换成定制版面模型,后面的识别和阅读顺序继续交给 OXR。官方将这种独立可插拔设计列为特点;具体接入仍要按接口对齐,不能理解成任意模型接上就能用。
最后是 RSI,也是我觉得值得展开说的一部分。
SoMark 的说明是,OXR 从零预训练,在后训练阶段使用面向文档解析的递归自我改进闭环。团队称这是文档解析中的首次引入;这里保留的是团队的技术主张。RSI 说明(https://github.com/SoMarkAI/OXR/blob/main/README_CN.md)
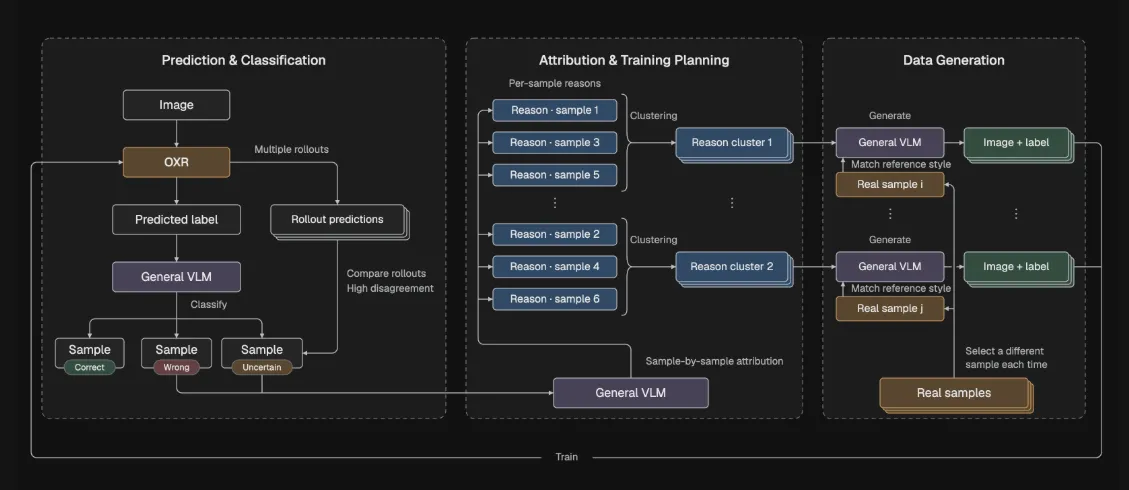
官方 RSI 训练闭环
可以把它理解成围绕错题反复练习:先找出容易出错或能力薄弱的样本,分析问题,再补针对性的数据和训练,随后重新评估,继续下一轮。
真正值得关注的,不是给这个循环起了什么名字,而是官方称这套流程不需要人工新增标注,就能针对弱项迭代。
这不等于整个模型从头到尾都没有用人工数据。它说的是这一段改进闭环。文档标注本来就费工,能缩短这个环节,对迭代速度很有价值。
尾声
大家都在往全能 Agent 上走,OXR 选的是先把一页纸读明白。这种专注,我挺认可。
SoMark 提供了在线 Demo、免费试用 API,也给出了本地部署方案、vLLM 插件和配套工具。想试,不一定一上来就搭完整环境。项目入口(https://github.com/SoMarkAI/OXR)
不过,免费 API 官方明确不保证稳定性,设有排队机制,不建议用于线上生产;本地部署也有显卡和环境要求。生产使用还应阅读项目的自定义许可证,开源不等于没有使用条件。
如果手上正有难解析的文档,可以先拿一份不含敏感信息的材料,核对表头、公式、注释和阅读顺序,再决定要不要接进知识库。
我这次最大的感受是:看小模型,不能只看参数量。
Agent 要把后面的事做好,前面的材料总得先读对。
参考资料
- OXR 官方中文说明:能力、架构、RSI、使用入口及限制
- OXR 官方评测:对比范围、准确率快照及测速条件
- OXR 官方发布页
关于作者 我叫殷新伟,号南殷居士,以“南殷用AI”分享实践与思考。我是一名数据与 AI 产品从业者,关注企业 AI 应用、FDE 实战,以及专业经验如何转化为可复用的产品、技能和工作流。个人站:南殷用AI(nanyinai.vip)。
关注公众号「南殷用AI」
用微信扫描下方二维码,或在微信搜一搜搜索「南殷用AI」。
手机上可长按图片识别二维码;点击图片可放大查看。